集合篇,本章主要讲解Java中常见集合的底层原理。
在开始之前,让我们先总览一下java集合框架体系
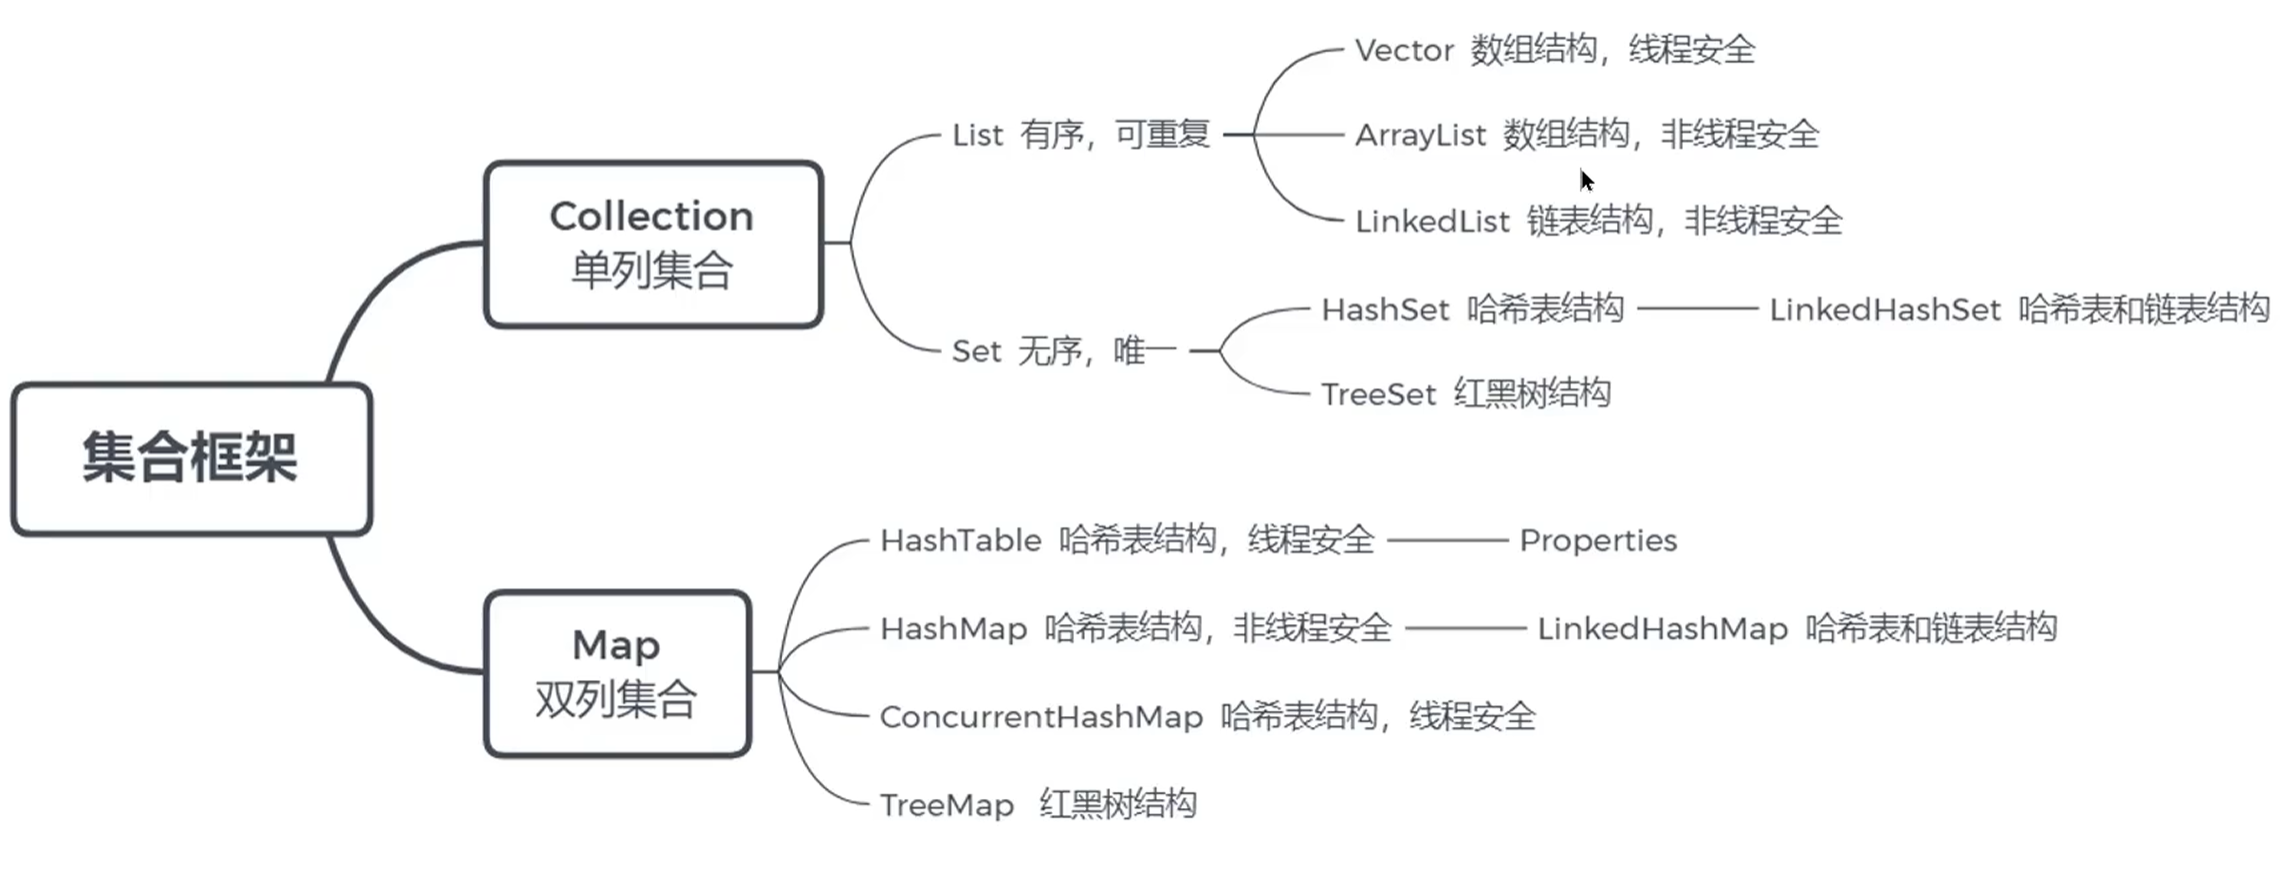
这么多集合我们都要学习吗?不是的,其中有一些集合因为某些原因已经不再推荐使用 了,例如Vector和HashTable,这两种集合虽然是线程安全的,但是它们实现线程安全的方式非常简单粗暴,那就是在方法声明上加上synchronized锁,对整个方法加锁,显然这种锁的粒度太粗了,性能很差,因此现在已经很少使用了,本章主要讲解的是ArrayList、LinkedList、HashMap、ConcurrentHashMap、TreeMap等使用场景比较多的集合。
本章会按照图中的结构来依次分析List、Set、Map三种集合,并对其中的部分实现类进行底层原理的讲解和源码分析以及对应集合的面试题。在分析每个集合的底层结构时,我们主要聚集于成员变量、构造函数、核心方法讲解集合的涉及思想。
本章中的所有代码均来自于JDK25。
List
List是单列有序集合,集合中的元素可重复,其实现类有Vector,ArrayList,LinkedList等,这里主要讲解ArrayList和LinkedList,Vector因为锁粒度太粗,性能较差,不推荐使用了。
ArrayList
ArrayList简单来说就是一个会动态扩容的数组,底层基于数组存储数据,使用数组的好处是查找极快,只要知道索引就可以在O(1)的时间内查找到数据,如果数组满了就会按照一定规则扩容,扩容会创建一个更大的数组,将老数组的元素拷贝到新数组中。
成员变量
以下是ArrayList核心成员变量
// 默认数组的初始容量
private static final int DEFAULT_CAPACITY = 10;
// 用于空实例的共享空数组实例
private static final Object[] EMPTY_ELEMENTDATA = {};
// 用于默认大小的空实例的共享空数组实例,与 EMPTY_ELEMENTDATA 作用类似
private static final Object[] DEFAULTCAPACITY_EMPTY_ELEMENTDATA = {};
// 实际存储元素的数组。
// 当添加第一个元素时,任何elementData == DEFAULTCAPACITY_EMPTY_ELEMENTDATA的空ArrayList都将扩展为 DEFAULT_CAPACITY
transient Object[] elementData;
// ArrayList的大小,即当前元素的数量
private int size;构造方法
/*
带初始化容量的构造方法,如果容量合法则将elementData初始化为指定容量大小的数组
如果传入的容量不合法(< 0),则抛出非法参数异常。
*/
public ArrayList(int initialCapacity) {
if (initialCapacity > 0) {
this.elementData = new Object[initialCapacity];
} else if (initialCapacity == 0) {
this.elementData = EMPTY_ELEMENTDATA;
} else {
throw new IllegalArgumentException("Illegal Capacity: "+
initialCapacity);
}
}
/*
空参构造方法,将elementData设置为默认的静态空集合
*/
public ArrayList() {
this.elementData = DEFAULTCAPACITY_EMPTY_ELEMENTDATA;
}
/*
使用其他单列集合初始化ArrayList
将传入的Collection集合转换为数组,然后将数组的值赋值给elementData
*/
public ArrayList(Collection<? extends E> c) {
Object[] a = c.toArray();
if ((size = a.length) != 0) {
// 如果传入的集合也是ArrayList,则直赋值即可
if (c.getClass() == ArrayList.class) {
elementData = a;
} else {
// 将数组拷贝到elementData中
elementData = Arrays.copyOf(a, size, Object[].class);
}
} else {
// 如果传入的collection为空,用空集合替换。
elementData = EMPTY_ELEMENTDATA;
}
}核心方法
ArrayList的核心方法主要就是增加元素和扩容操作了,添加元素的方法是ArrayList.add()方法,add方法首先会判断数组是否已经满了,如果满了就触发扩容机制,未满则直接在数组末尾添加元素。扩容机制后面会详细讲解,这里先暂时略过。
/*
如果elementData已经满了则扩容,扩容之后再添加元素
*/
private void add(E e, Object[] elementData, int s) {
if (s == elementData.length)
elementData = grow();
elementData[s] = e;
size = s + 1;
}
/*
向ArrayList末尾添加一个元素
*/
public boolean add(E e) {
modCount++;
add(e, elementData, size);
return true;
}扩容操作核心逻辑,grow()方法内部第一个if块是扩容的核心逻辑,else块中是第一次扩容才会触发的逻辑,即初始化elementData数组。从第一个if块中可以看到扩容的核心逻辑就是调用了ArraysSupport.newLength(),该方法接收三个参数,第一个参数是原容量,第二个参数是最小扩容数量,第三个是预扩容量,方法内部会选择原容量加上后面两个参数的较大者作为新容量返回。最后使用Arrays.copyOf()方法将原数组拷贝到新数组中并赋值给elementData。
private Object[] grow(int minCapacity) {
int oldCapacity = elementData.length;
if (oldCapacity > 0 || elementData != DEFAULTCAPACITY_EMPTY_ELEMENTDATA) {
int newCapacity = ArraysSupport.newLength(oldCapacity,
minCapacity - oldCapacity, /* minimum growth */
oldCapacity >> 1 /* preferred growth */);
return elementData = Arrays.copyOf(elementData, newCapacity);
} else {
return elementData = new Object[Math.max(DEFAULT_CAPACITY, minCapacity)];
}
}
private Object[] grow() {
return grow(size + 1);
}ArrayList底层原理总结:
ArrayList底层是使用动态数组实现的。
初始容量为0,当第一次添加数据的时候会扩容为10.
数组在进行扩容的时候会将容量扩大到原来的1.5倍,每次扩容都会拷贝原数组到一个更大的数组中。
ArrayList在向数组中添加数据的时候会先检查数组有没有满,如果满了就先扩容再添加元素。
由于使用数组实现,因此索引查询效率很高,但是增加或删除元素效率很低,因为数组在内存上是连续的
LinkedList
LinkedList是基于双向链表实现的单列集合。其将节点node定义为一个内部类,其内部类源码如下,节点的结构和普通双向链表一样。
private static class Node<E> {
E item;
Node<E> next;
Node<E> prev;
Node(Node<E> prev, E element, Node<E> next) {
this.item = element;
this.next = next;
this.prev = prev;
}
}成员变量
LinkedList的核心成员变量只有三个,分别是表示链表长度,链表头节点、尾节点。
transient int size = 0; // 链表长度
transient Node<E> first; // 链表头指针
transient Node<E> last; // 链表尾指针构造方法
LinkedList的构造方法实现同样很简单,只有两个。空参构造默认不执行任何逻辑,使用另一个Collection初始化LinkedList会调用addAll()方法将集合中的方法全部添加到List中。
public LinkedList() {
}
@SuppressWarnings("this-escape")
public LinkedList(Collection<? extends E> c) {
this();
addAll(c);
}
public boolean addAll(Collection<? extends E> c) {
return addAll(size, c);
}
public boolean addAll(int index, Collection<? extends E> c) {
// 位置校验,校验index的合法性
checkPositionIndex(index);
// 集合数组转快照,避免插入的Collection与当前链表是同一对象
Object[] a = c.toArray();
int numNew = a.length;
// 空集合短路,如果插入的是空链表,则不做任何修改。
if (numNew == 0)
return false;
// 定义前驱和后继,将新链表插入在pred和succ之间
Node<E> pred, succ;
if (index == size) {
succ = null;
pred = last;
} else {
succ = node(index);
pred = succ.prev;
}
// 逐节点创建并正向连接
for (Object o : a) {
@SuppressWarnings("unchecked") E e = (E) o;
Node<E> newNode = new Node<>(pred, e, null);
if (pred == null)
first = newNode;
else
pred.next = newNode;
pred = newNode;
}
// 把新插入的节点链与预先找到的后继节点succ连接起来。
if (succ == null) {
last = pred;
} else {
pred.next = succ;
succ.prev = pred;
}
size += numNew;
modCount++;
return true;
}核心方法
相比于ArrayList,LinkedList不需要扩容,因为链表本身就是随加随插入的,添加元素时调用add()方法,方法内部会调用linkLast()将元素插入到链表尾部。
public boolean add(E e) {
linkLast(e);
return true;
}
// 将元素添加到链表尾部
void linkLast(E e) {
final Node<E> l = last;
final Node<E> newNode = new Node<>(l, e, null);
last = newNode;
if (l == null)
first = newNode;
else
l.next = newNode;
size++;
modCount++;
}总的来说LinkedList的实现比较简单,一般没有太多考察的知识点,简单了解即可,相比于ArrayList,由于底层实现的不同,LinkedList在插入和删除的性能上会更好,但是查询性能较差,一般在实际开发中使用场景不如ArrayList广泛。
ArrayList和LinkedList的区别
ArrayList和LinkedList因为其底层实现不同,造成在查找效率,空间利用等都有明显差异。
底层数据结构
ArrayList底层使用动态数组实现,数组满了会自动扩容。
LinkedList底层使用双向链表实现。
操作数据效率
ArrayList索引查找效率为O(1),LinkedList不支持下标查询。
未知索引查找ArrayList和LinkedList效率都是O(n)
ArrayList和LinkedList增删元素效率都是O(n)
内存空间使用(默认数据量相同)
ArrayList底层采用数组实现,连续内存,节省空间。
LinkedList使用双向链表实现,需要为每个元素维护额外指针,占用空间更多
线程安全性
ArrayList和LinkedList都是线程不安全的,如果需要线程安全的实现有两种方案:
在方法内使用,局部变量可以保证线程安全。
如果一定需要共享使用集合,可以使用
Collections.synchronizedList()方法来获取一个线程安全的集合,但是这种方法获取的集合只是简单的在所有方法标签上加synchronized锁,性能较差。
Map
在讲解Set之前,我们先讲解Map双列集合,因为Set的实现类基本都是以Map为基础的,例如HashSet实际存储元素的数据结构就是HashMap,TreeSet存储元素的数据结构就是TreeMap。Map的主要实现类有HashMap、ConcurrentHashMap、TreeMap,LinkedHashMap和HashTable因为性能原因或其他原因使用场景并不多,暂时略过。
HashMap
HashMap是在哈希表和红黑树的基础上实现的散列表,其可以根据键的hash值快速地查找到对应的键值对,查询性能很高,底层采用数组、链表、红黑树结构实现。HashMap在插入元素时会先计算key的hash值,然后找到对应的桶节点,将键值对放入对应的桶中,如果该位置已经有元素了(产生了哈希冲突),HashMap会采用拉链法解决哈希冲突,即将哈希冲突的节点串成一个链表。
当容器中元素数量比较大时,哈希冲突会比较严重,每个桶的链表长度越来越长,而链表的查询效率是比较低的,因此当链表的节点数量超过阈值时并且桶数组容量也大于一定阈值时,为了提高查找效率,HashMap会将链表转换为红黑树,红黑树的查找和增删改效率是比较稳定的。不直接将链表转换为红黑树是因为当桶数组比较小时,出现哈希冲突的原因大概率是因为桶数组太小,此时应该优先扩容而非树化,将节点分散开比树化更划算。
成员变量
// 默认桶数组初始容量为32
static final int DEFAULT_INITIAL_CAPACITY = 1 << 4;
// 桶数组的最大容量,int第一位是符号位,因此最大容量就是2^30
static final int MAXIMUM_CAPACITY = 1 << 30;
// 默认负载因子,桶数组扩容的容量与负载因子有关。扩容阈值 = 数组容量 * 负载因子。
static final float DEFAULT_LOAD_FACTOR = 0.75f;
// 链表转红黑树阈值,当单个桶的链表节点数量达到这个阈值时会将链表转换为红黑树
static final int TREEIFY_THRESHOLD = 8;
// 红黑树转链表阈值,当单个桶的红黑树节点数量小于这个值时会将红黑树转回链表
static final int UNTREEIFY_THRESHOLD = 6;
// 允许树化的最小容量,当桶数组比较小时,出现哈希冲突更可能是因为桶数组容量太小,此时应该优先扩容。
static final int MIN_TREEIFY_CAPACITY = 64;
// 哈希桶数组,实际存储Map键值对的容器
transient Node<K,V>[] table;
// 集合大小,即当前元素个数
transient int size;
// 扩容阈值,当size > threshold时触发扩容操作
int threshold;
// 负载因子,可以在构造方法中指定,final修饰,不可修改
final float loadFactor;
// 键值对类定义,同时有一个指向下一个键值对的指针用来处理哈希冲突
// HashMap使用拉链法解决哈希冲突
static class Node<K,V> implements Map.Entry<K,V> {
final int hash;
final K key;
V value;
Node<K,V> next;
Node(int hash, K key, V value, Node<K,V> next) {
this.hash = hash;
this.key = key;
this.value = value;
this.next = next;
}
}构造方法
HashMap的构造方法比较多,这里只讲解参数最多最全的构造方法,参数分别为初始容量以及我们自己指定的负载因子。构造方法内部会先校验初始容量和负载因子的合法性,检验无误后执行方法tableSizeFor(),该方法会返回大于等于initialCapacity的最小的2的幂作为初始容量。
容量设置为2的幂的原因:在 HashMap 中计算key的槽位下标使用的是 hash(key) & (size - 1),其中 hash 方法会充分利用 key 的 hashcode 方法的每一位尽量得出一个独特的 hash 值,这个与 key 本身有关,得到的 hash 值需要与 size - 1 进行与运算。如果 size 的值为2的幂,那么 size - 1 就会得到一个全为 1 的二进制数,二进制全为 1 可以确保哈希码的低位全部都会保留在最后的结果中,利用上 hash 码全部的二进制位,可以使哈希冲突更少,元素分布更均匀。同时如果容量为 2 的幂,可以用效率更高的位运算代替取模运算。
hash() 方法对 key 的哈希值的计算也很有讲究,其使用的是 key 的 hashcode 和自身的高16位进行与运算,这样可以充分利用 key 的每一位 hashcode,使得最终得出的结果尽可能不同。
因为size的大小是2的幂,因此 hash(key) & (size - 1) 的效果等价于 hash(key) % size,但是位运算的效率是比基本运算的效率更高的,所以在这里选择位运算,其实 HashMap 中的哈希函数就是对容量取模,将容量设置为2的幂更能利用到哈希值的所有低位,使得哈希冲突尽可能减少。
public HashMap(int initialCapacity, float loadFactor) {
if (initialCapacity < 0)
throw new IllegalArgumentException("Illegal initial capacity: " +
initialCapacity);
if (initialCapacity > MAXIMUM_CAPACITY)
initialCapacity = MAXIMUM_CAPACITY;
if (loadFactor <= 0 || Float.isNaN(loadFactor))
throw new IllegalArgumentException("Illegal load factor: " +
loadFactor);
this.loadFactor = loadFactor;
this.threshold = tableSizeFor(initialCapacity);
}
// 返回大于等于cap的最小的2的幂
static final int tableSizeFor(int cap) {
int n = -1 >>> Integer.numberOfLeadingZeros(cap - 1);
return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1;
}核心方法
HashMap的核心方法包括插入,扩容、查找、删除操作。其中涉及到对红黑树的节点进行添加或删除的操作暂时不讲解,这部分也被封装了一个方法对外提供,例如putTreeVal(),getTreeNode()等方法,因为红黑树的操作比较复杂,属于数据结构的内容,在此不做讲解。
首先来看查找操作,在查找操作内部,会调用getNode()方法根据key获取对应的value。在getNode方法内部会先判断散列表是否为空,如果没能成功进入if块说明此时HashMap中还没有元素,直接返回null。使用tab[(n - 1) & (hash = hash(key))]获取到对应桶的头节点,其中下标的计算方法在前面已经讲过原理了,如果该槽位上没有元素也无法进入if块。进入if块之后首先会检查头节点是否就是当前要找的元素,如果是直接返回value。如果不是说明发生了哈希冲突,需要继续向下寻找,向下寻找的过程中首先会根据node的类型判断该桶是否已经树化,根据是否树化会选择不同的方法来获取对应的value。
二次哈希寻址算法讲解:因为 size 的值一般不会很大,所以在进行与运算时只会用到哈希码的低位,哈希码的高位实际上在大部分情况下不会参与运算的,这会提高哈希冲突的概率,使用 key 的 hashcode 与自身高16位进行异或运算,会使最终得到的 hash 值的低位中包含高位的信息。通过混合低16位和高16位的信息,增加了哈希值的随机性,减少了哈希冲突的概率。这种算法也被称为二次哈希寻址算法。
public V get(Object key) {
Node<K,V> e;
return (e = getNode(key)) == null ? null : e.value;
}
final Node<K,V> getNode(Object key) {
Node<K,V>[] tab; Node<K,V> first, e; int n, hash; K k;
if ((tab = table) != null && (n = tab.length) > 0 &&
(first = tab[(n - 1) & (hash = hash(key))]) != null) {
// 判断第一个key是否就是我们要找的key
if (first.hash == hash && // always check first node
((k = first.key) == key || (key != null && key.equals(k))))
return first;
// 如果第一个key不是目标key
if ((e = first.next) != null) {
// 已经树化,需要根据红黑树的搜索方式查找
if (first instanceof TreeNode)
return ((TreeNode<K,V>)first).getTreeNode(hash, key);
do {
// 没有树化,还是链表,沿着链表寻找目标key即可
if (e.hash == hash &&
((k = e.key) == key || (key != null && key.equals(k))))
return e;
} while ((e = e.next) != null);
}
}
return null;
}
// 计算hash码,将key的hashcode与其高十六位进行异或运算,尽量使结果独一无二,减少哈希冲突
static final int hash(Object key) {
int h;
return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
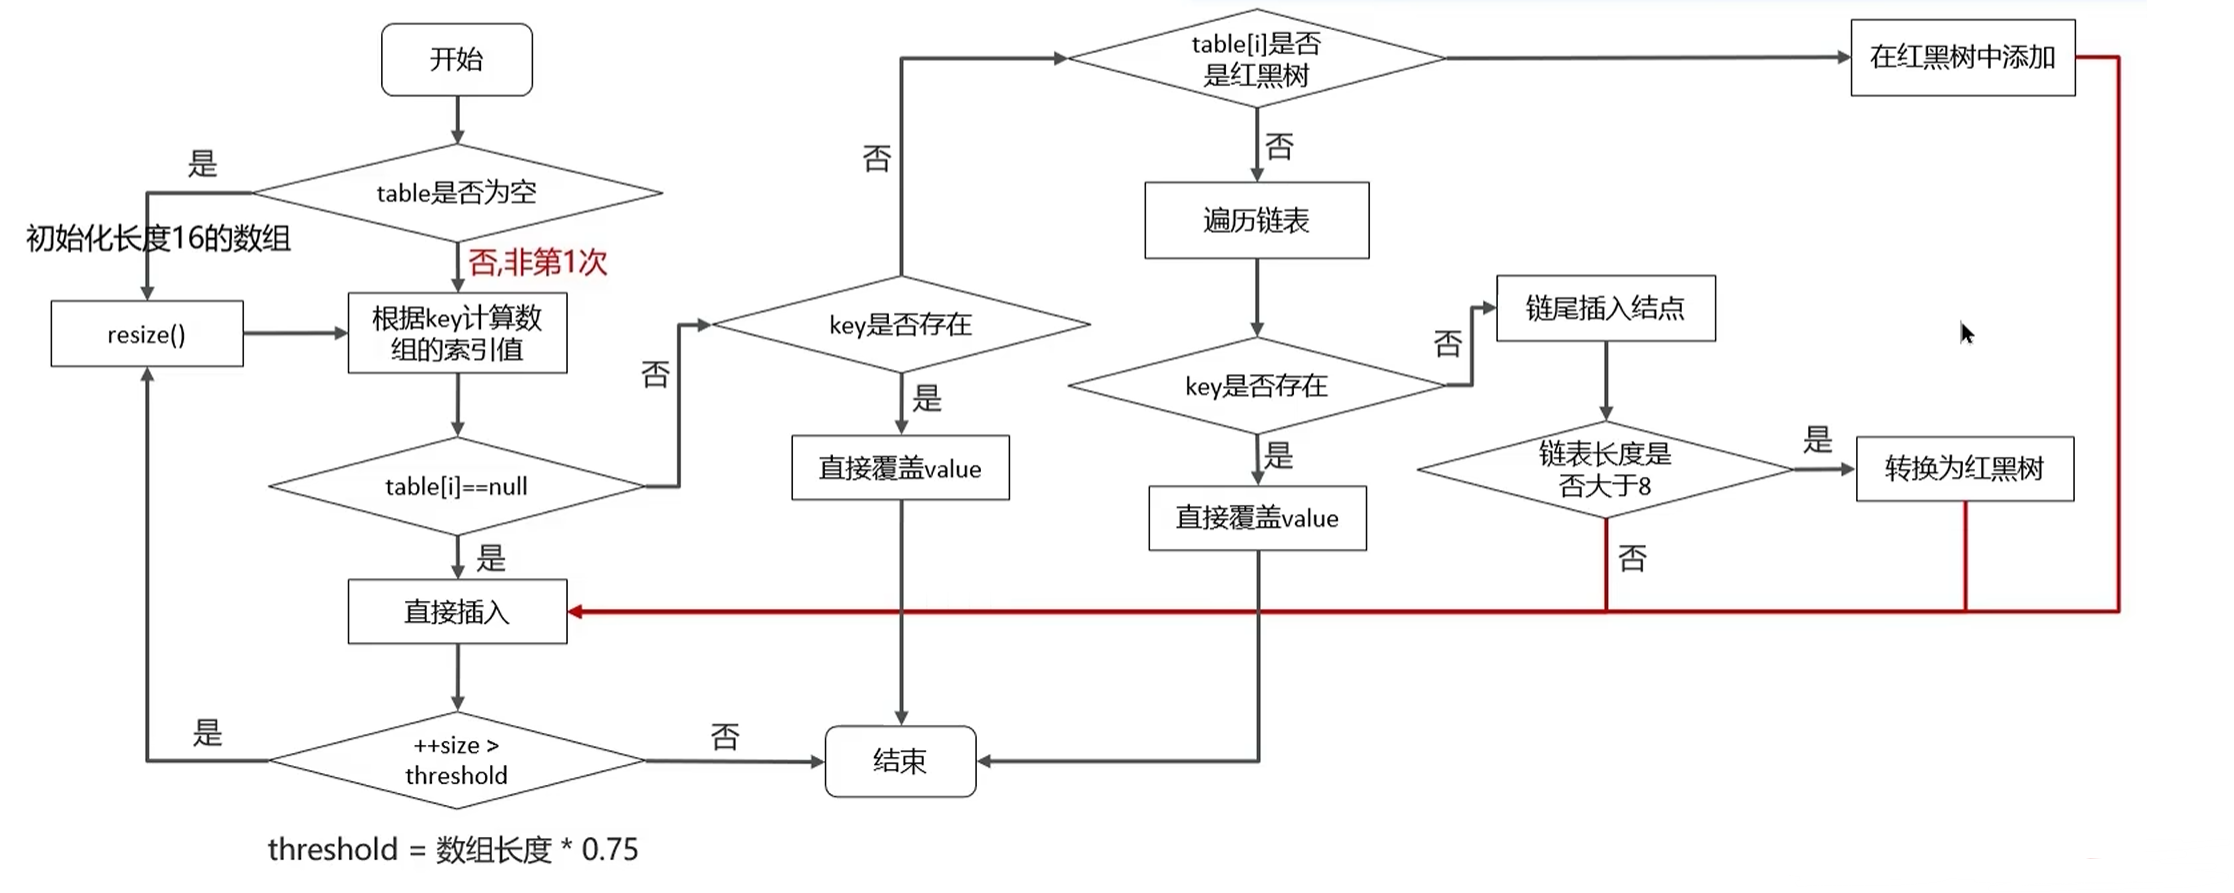
}插入和扩容操作放在一起讲解,因为插入必然会涉及到扩容。所有涉及添加元素的方法(put、putAll、putIfAbsent)等最终都会汇聚到putVal()方法上,只有这个方法是真正添加元素的方法。在putVal()方法中先判断HashMap是否为空,如果为空则会先调用resize()初始化HashMap;如果当前桶没有节点则直接将节点放入桶中;如果已经有元素,说明发生了哈希冲突,需要根据是否树化来执行不同的添加逻辑。
putVal()方法流程图
public V put(K key, V value) {
return putVal(hash(key), key, value, false, true);
}
// 参onlyIfAbsent表示只有这个桶不存在元素时才插入元素,evict参数不重要,按下不表
final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
boolean evict) {
Node<K,V>[] tab; Node<K,V> p; int n, i;
// 如果HashMap为空则先扩容(初始化)
if ((tab = table) == null || (n = tab.length) == 0)
n = (tab = resize()).length;
// 如果当前桶没有元素则直接将键值对放在桶的位置上
if ((p = tab[i = (n - 1) & hash]) == null)
tab[i] = newNode(hash, key, value, null);
// 当前桶已经有元素了,说明发生了哈希冲突
else {
Node<K,V> e; K k; // e表示查找到对应key的entry
// 如果第一个元素,如果第一个元素恰好就使传入的key,则直接赋值给e
if (p.hash == hash &&
((k = p.key) == key || (key != null && key.equals(k))))
e = p;
// 该桶已经树化,使用putTreeVal方法向红黑树添加节点
else if (p instanceof TreeNode)
e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
// 在链表中寻找目标key
else {
for (int binCount = 0; ; ++binCount) {
// 如果遍历到了尾节点还没有找到直接在节点尾部接上新节点
if ((e = p.next) == null) {
p.next = newNode(hash, key, value, null);
// 添加完元素后需要判断是否需要树化
if (binCount >= TREEIFY_THRESHOLD - 1)
treeifyBin(tab, hash);
break;
}
// 如果找到了目标key就break,说明此时使修改操作
if (e.hash == hash &&
((k = e.key) == key || (key != null && key.equals(k))))
break;
p = e;
}
}
// 如果找到了目标node,说明该键值对已经存在,需要进行修改操作。
if (e != null) { // existing mapping for key
V oldValue = e.value;
if (!onlyIfAbsent || oldValue == null)
e.value = value;
afterNodeAccess(e);
return oldValue;
}
}
// 如果添加元素之后达到了阈值则需要扩容
++modCount;
if (++size > threshold)
resize();
afterNodeInsertion(evict);
return null;
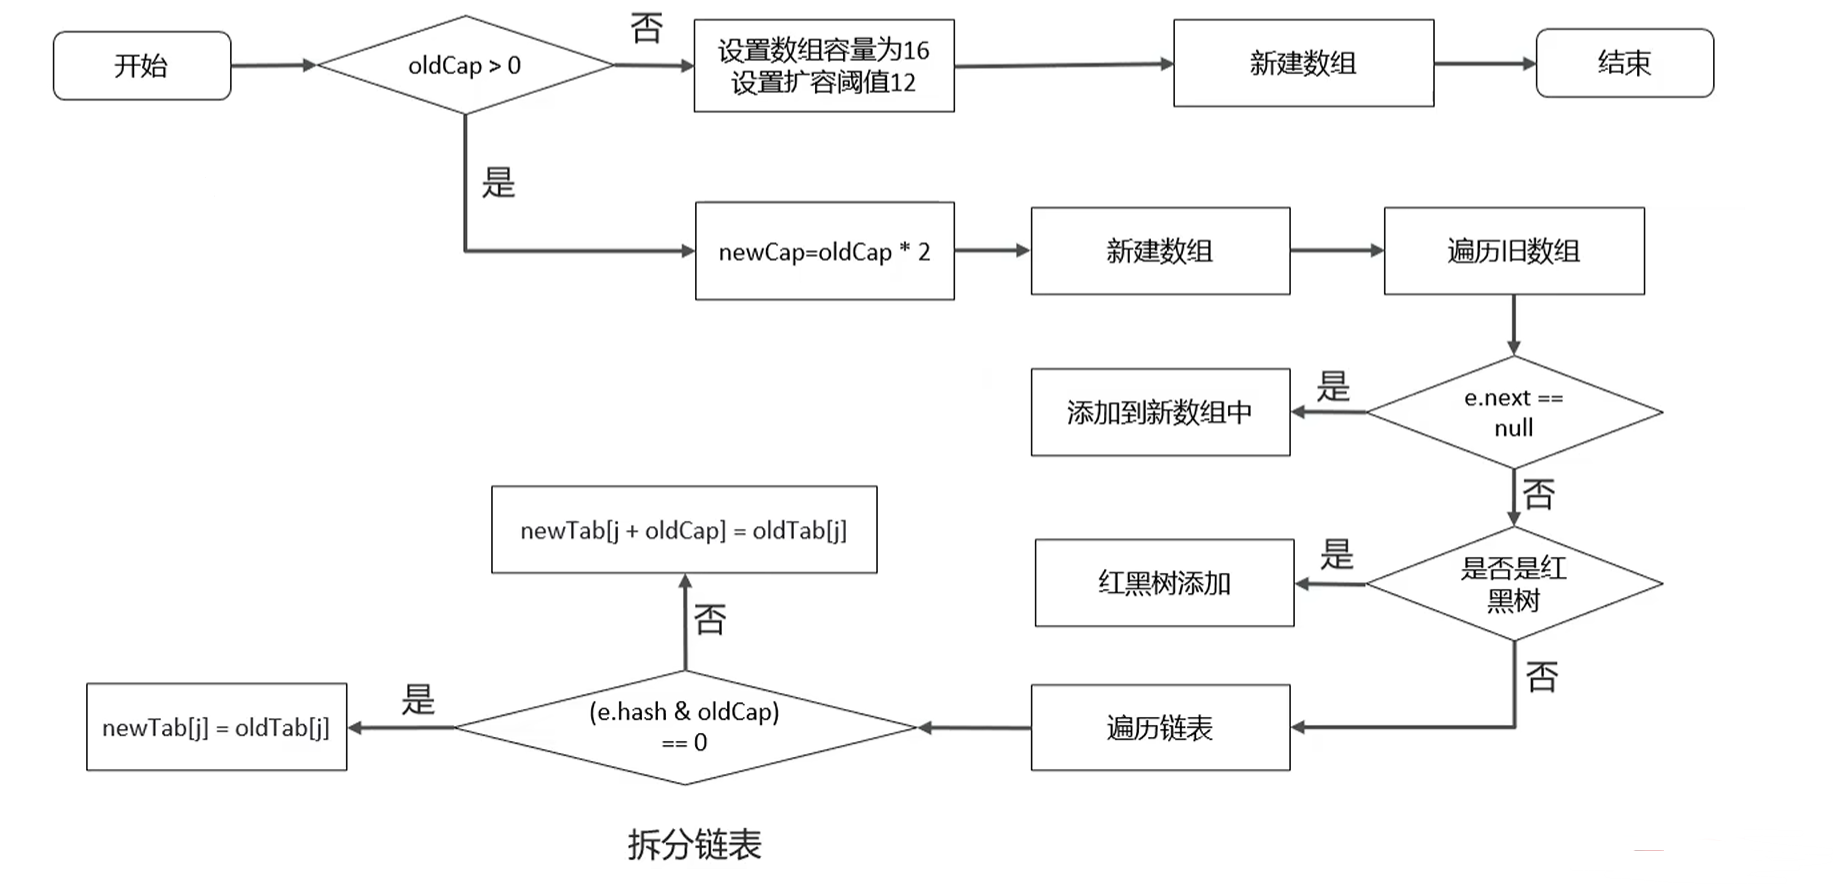
}扩容操作的过程被封装在了resize()方法中。方法内部首先会根据旧的扩容阈值和容量来计算新的扩容阈值和容量,如果旧容量(oldCap)大于0,说明table不为空,是正常的扩容,那么新的容量和新的扩容阈值都是原来的二倍(全部左移一位);如果旧容量为0,但是扩容阈值不为0,说明HashMap此时只执行完有参构造方法(有参构造方法会将初始容量赋值给threshold而不是size),直接将旧的扩容阈值赋值给新容量即可,如果旧的容量和扩容阈值全部为0,说明此时刚刚执行完无参构造方法,新容量直接就是默认容量DEFAULT_INITIAL_CAPACITY(16);在确定新容量和新的扩容阈值之后就可以开始执行实际的扩容操作了。
扩容操作会遍历所有桶,如果桶中只有一个元素,则可以直接计算元素在新数组中的下标并放入;如果桶中存放的是红黑树,则执行红黑树的转移逻辑;如果桶中存放的是链表,则会遍历链表,因为扩容之后所有元素的hash值需要重新计算,部分元素的桶下标可能会改变,因此需要两个链表,一个链表存放桶下标不变的元素,另一个链表存放桶下标改变的元素,当所有元素遍历完成之后,就可以将链表放到新数组中对应的槽位上了。
双链搬运机制讲解:因为每次扩容都会将容量增加一倍,也就是意味着 size - 1 会多一位1,在与 key 的 hash 值做与运算时,如果多的这一位在哈希码中是 1,那么该 key 在新数组的中的位置就会增加,并且只会多这一位1,而这一位1对应的正好是旧容量 oldCap 的那一位,后面低位不变,则新下标就是 j + oldCap ;如果哈希码中这一位是0,那么与 size - 1 做与运算之后还是原来的值,即还是原来的桶下标 j ,所以原链表中的节点的哈希码对新容量取余的结果只有两个,要么还是 j ,要么是 j + oldCap,所以只需要两个链表即可完成转移。
并且转移到的新数组的槽位一定是空的,因为 j 是从0开始到 oldCap - 1的,所以不会 j 和 j + oldCap是不会重复的,新数组的每个桶都对应唯一的旧数组中的桶。
扩容操作resize()流程图
 final Node<K,V>[] resize() {
     Node<K,V>[] oldTab = table;
     int oldCap = (oldTab == null) ? 0 : oldTab.length; // 旧容量
     int oldThr = threshold; // 旧的扩容阈值
     int newCap, newThr = 0; // 新容量和新的扩容阈值
     // 如果原来的table不为空,即旧容量不为0
     if (oldCap > 0) {
         // 健壮性校验,如果旧容量已经达到上限则无法进行扩容
         if (oldCap >= MAXIMUM_CAPACITY) {
             threshold = Integer.MAX_VALUE;
             return oldTab;
         }
         else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY &&
                  oldCap >= DEFAULT_INITIAL_CAPACITY)
             newThr = oldThr << 1; // double threshold
     }
     // 容量为0但是扩容阈值不为0,说明HashMap此时只执行了构造函数,将初始容量赋值给了threshold
     else if (oldThr > 0)
         newCap = oldThr;
     // 无参构造的首次put
     else {
         newCap = DEFAULT_INITIAL_CAPACITY;
         newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY);
     }
     // 第二种情况的补充,一开始threshold存储的是初始容量,现在需要将其设置成新容量的扩容阈值。
     if (newThr == 0) {
         float ft = (float)newCap * loadFactor;
         newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ?
                   (int)ft : Integer.MAX_VALUE);
     }
     threshold = newThr;
     @SuppressWarnings({"rawtypes","unchecked"})
     Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap];
     table = newTab;
     if (oldTab != null) {
         // 遍历桶数组开始转移节点到新的桶数组中
         for (int j = 0; j < oldCap; ++j) {
             Node<K,V> e;
             if ((e = oldTab[j]) != null) {
                 oldTab[j] = null;
                 // 如果该桶中只有一个节点,则直接转移到新数组中对应位置即可
                 if (e.next == null)
                     newTab[e.hash & (newCap - 1)] = e;
                 // 如果该桶存放的是树,则执行红黑树的转移逻辑
                 else if (e instanceof TreeNode)
                     ((TreeNode<K,V>)e).split(this, newTab, j, oldCap);
                 // 桶存放的是链表
                 else {
                     Node<K,V> loHead = null, loTail = null;
                     Node<K,V> hiHead = null, hiTail = null;
                     Node<K,V> next;
                     do {
                         next = e.next;
                         // 存储桶下标不改变节点
                         if ((e.hash & oldCap) == 0) {
                             if (loTail == null)
                                 loHead = e;
                             else
                                 loTail.next = e;
                             loTail = e;
                         }
                         // 桶下标改变的节点
                         else {
                             if (hiTail == null)
                                 hiHead = e;
                             else
                                 hiTail.next = e;
                             hiTail = e;
                         }
                     } while ((e = next) != null);
                     // 将两个链表分别放到新数组中对应的桶中
                     if (loTail != null) {
                         loTail.next = null;
                         newTab[j] = loHead;
                     }
                     if (hiTail != null) {
                         hiTail.next = null;
                         newTab[j + oldCap] = hiHead;
                     }
                 }
             }
         }
     }
     return newTab;
}删除节点操作,所有有关删除节点的操作全部由removeNode()完成,在方法内部会先判断HashMap是否为空,如果为空则直接跳过,不进入if块。在if块中会首先判断槽位上存放的节点是否就是目标key,如果是目标key直接结束,执行删除逻辑;如果p有后继节点,则根据节点类型执行不同的逻辑,如果已经树化,则执行getTreeNode()方法获取目标key对应的树节点,如果还没有树化则遍历链表寻找目标key。最终执行完毕之后node就是待删除键值对,如果node为null说明HashMap中不存在对应键值对,直接忽略;不为null则执行删除逻辑。
public V remove(Object key) {
Node<K,V> e;
return (e = removeNode(hash(key), key, null, false, true)) == null ?
null : e.value;
}
final Node<K,V> removeNode(int hash, Object key, Object value,
boolean matchValue, boolean movable) {
Node<K,V>[] tab; Node<K,V> p; int n, index;
// 判断HahsMap不为空
if ((tab = table) != null && (n = tab.length) > 0 &&
(p = tab[index = (n - 1) & hash]) != null) {
Node<K,V> node = null, e; K k; V v;
// 如果槽位上存放的就是目标key则直接将p赋值给node。
if (p.hash == hash &&
((k = p.key) == key || (key != null && key.equals(k))))
node = p;
// 如果p有后继节点,则根据节点类型执行不同的删除逻辑
else if ((e = p.next) != null) {
if (p instanceof TreeNode)
node = ((TreeNode<K,V>)p).getTreeNode(hash, key);
else {
do {
if (e.hash == hash &&
((k = e.key) == key ||
(key != null && key.equals(k)))) {
node = e;
break;
}
p = e;
} while ((e = e.next) != null);
}
}
// node是最后找到的目标key,如果为null说明不存在,直接忽略
if (node != null && (!matchValue || (v = node.value) == value ||
(value != null && value.equals(v)))) {
if (node instanceof TreeNode)
((TreeNode<K,V>)node).removeTreeNode(this, tab, movable);
else if (node == p)
tab[index] = node.next;
else
p.next = node.next;
++modCount;
--size;
afterNodeRemoval(node);
return node;
}
}
return null;
}HashMap总结:HashMap底层使用数组和红黑树和链表实现,当向HashMap中put元素时,首先会计算出key的hash值,也就是对应的桶下标,如果出现哈希冲突,则会在对应的桶下面挂一个链表,当链表长度超过阈值,但是桶数组容量较小时,会优先扩容,因为此时出现哈希冲突大概率是因为槽位太少,当数组足够大但是依然哈希冲突严重时,过长的链表会使查询效率大幅度降低,此时会将链表转换为查询效率更稳定的红黑树。
为了避免频繁的哈希冲突,HashMap在数组容量达到扩容阈值时会进行扩容,当size >= capacity * loadFactor时则会调用resize()方法进行扩容,每次扩容默认是提升一倍的容量。每次扩容都会创建一个新的桶数组,并将老数组中的数据按照转移规则转移到新数组中。
JDK1.7和1.8中的HashMap的区别:
链表转红黑树的机制是1.8之后才引入的,在1.7及之前所有桶都是直接挂一个链表,这会导致在哈希冲突严重时查询效率退化为O(n),为了保证查询效率,在1.8之后引入了当链表长度大于8且当前数组长度大于等于64时转为红黑树的机制,这个阈值也是有讲究的,根据概率学原理,在哈希分布均匀的情况下,一个桶中有八个节点的概率极小,所以链表转红黑树机制也是 JDK 做的一个防御手段,正常业务几乎不会走到树化逻辑,树化主要用来对抗恶意 hash 攻击(如DDos)或很差的hash实现。
在1.7中迁移桶节点时候使用的是头插法,在1.8中使用的是尾插法。使用头插法在并发扩容时会有线程安全问题,典型后果是死循环、数据丢失、数据覆盖。
 // transfer 迁移核心代码 JDK1.7
 for (Entry<K,V> e : table) {
     while(null != e) {
         Entry<K,V> next = e.next;   // 保存下一个节点
         int i = indexFor(newCapacity, e.hash); // 合法性校验
         e.next = newTable[i];       // 新链表头部指向旧链表头
         newTable[i] = e;            // 当前节点放到新数组头部(头插)
         e = next;                   // 继续遍历旧链表下一个
     }
 }
在JDK1.7中使用头插法迁移链表,原链表转移完成之后理论上是会以相反的顺序挂在桶节点上,这是正常情况下,但是在并发环境中,假设有两个线程同时在对HashMap扩容,链表结构是 1 --》 2 --》null。
线程1刚进入第一轮循环,执行到
newTable[i] = e;语句,即将要执行这一语句,此时e指向节点1,next指向节点2.此时CPU切换到线程2。线程2执行完了整个扩容流程,链表在新数组中变成了2 -- 》 1 --》 null。
此时切换回线程1,执行
newTable[i] = e;,将节点1放在链表头部。执行
e = next;,此时e = 节点2。进入第二轮循环,执行
Entry<K,V> next = e.next;,即next = 节点1。执行
e.next = newTable[i];,即节点2.next = 节点1。
newTable[i] = e;将节点2放在链表头部。
e = next,即e = 节点1.再进入下一轮循环,
Entry<K,V> next = e.next;,next = null。执行
e.next = newTable[i];,即节点1.next = 节点2,此时就形成了循环引用 2 --》1 --》2 。
newTable[i] = e;,将节点1放到槽位上。最后执行
table = newTable,将这个带有循环引用的桶数组赋值给 HashMap 的 table 。此后所有查询或增删改都会从 table 读取数据,一旦读取到这个桶中的循环链表,就会陷入死循环,CPU 飙升至100%。
正是因为在并发环境下进行扩容会出现这种安全问题,JDK 在1.8才会将头插法改为尾插法,以避免循环引用问题。
ConcurrentHashMap
HashMap虽然性能很好,但不是线程安全的,在并发修改时,会出现数据覆盖等问题,因此开发者需要为此编写大量同步代码,这会大大降低应用的性能,ConcurrentHashMap就是为了解决这个问题而生的,ConcurrentHashMap是线程安全地HashMap实现,其可以在并发环境下在保证线程安全的前提下提供较好的性能。
线程安全
ConcurrentHashMap基于 CAS + synchronized 实现线程安全,底层数据结构依然是数组 + 链表 + 红黑树,和HashMap结构几乎一致,并且做了线程安全控制。
在添加元素时,计算完key的槽位之后,如果桶为空,ConcurrentHashMap会尝试CAS放置Node,如果成功则结束,失败则自旋重试;如果桶不为空,则会尝试对该桶的首节点加synchronized锁,获取锁成功就可以遍历链表/红黑树添加节点,获取锁失败依然自旋重试。
ConcurrentHashMap的扩容机制也和HashMap有所不同。当线程发现元素数量达到阈值之后,会发起扩容,新建nextTable数组,当其他线程put/get元素时,如果发现桶节点是ForwardingNode,说明此时正在进行迁移,会帮助扩容线程一起进行迁移。
扩容过程
ConcurrentHashMap是为多线程设计的,HashMap是单线程设计的,因此二者在扩容及机制上是有所不同的。ConcurrentHashMap的扩容条件依然是达到阈值(容量 * 负载因子)。在扩容方法内部主要调用了transfer()方法来迁移元素。
由于在扩容的时候也会有线程来访问元素,ConcurrentHashMap使用一种特殊的节点ForwardingNode来表示该桶是否已经迁移,其他线程看到这个节点就正在进行扩容了,会直接去新的数组访问并且协助扩容。ForwardingNode是一个特殊node,其hash值为-1,不存真实数据,其他线程get节点时,如果看到ForwardingNode,会去nextTable寻找数据,但不会协助扩容。
transfer()迁移逻辑:每个线程认领一部分桶进行迁移,当遍历到桶时,有三种状态,如果桶为null,则直接CAS尝试放置ForwardingNode表示迁移已经完成;桶头是ForwardingNode,说明该桶已经迁移完成,直接跳过;如果桶中有真实节点,则执行迁移逻辑,首先使用synchronized锁住桶头,确保只有一个线程正在迁移,如果桶是红黑树,则执行红黑树的迁移逻辑,如果桶中是链表则使用双链拆分,将链表分为low链和high链(这部分同HashMap),迁移完成之后在桶上放置ForwardingNode,表示迁移完成。
多线程协助机制:ConcurrentHashMap扩容机制的另一个特点就是多线程协助扩容。当一个线程执行put/remove操作时,如果发现桶头是ForwardingNode,说明正在扩容,会加入协助扩容,进入transfer()逻辑帮助进行一部分桶数据进行迁移。多个线程分工搬运不同的槽位,全部搬运完成后将nextTable赋值给table,并更新size和新阈值。
ConcurrentHashMap 在JDK1.7和1.8的实现也是有很大差异的。
对于锁粒度,在1.7中,ConcurrentHashMap 的底层实现是分段锁 + 链表。将数组分成多个段,每个段包含若干个桶,添加元素时会锁住桶所在的整个段,每个段就是一把 ReentrantLock 。这种实现的缺点是锁粒度太粗,
put()方法一般只会操作某一个桶,但是分段锁会将段所在的所有桶全部锁住,操作段内其他桶的线程也无法进行操作,性能很差。因此 JDK8 在选择将锁的粒度减小到桶级别,put元素时只锁住对应的桶。在扩容机制上,1.7的 ConcurrentHashMap 扩容是在每个 segment 内部扩容的,即每个节点插入到 segment 对应的 node 数组后。如果该 segment 达到扩容阈值,那么会在 segment 内部进行扩容,不会影响到其他 segment ,并且只有拿到该 segment 锁的线程才可以执行扩容,没有多线程协助扩容的机制,因此这种扩容方式是比较慢的。
TreeMap
TreeMap是用纯红黑树实现的map,其就是一棵节点类型为entry的红黑树,要求key必须实现comparable接口或者传入自定义的比较器comparator用来比较key的大小。TreeMap最大的优势是key有序且支持区间查找key,而HashMap的key是无序的。但由于底层是红黑树实现,所以查找和增删改效率都是稳定的O(log n),HashMap的操作效率理想情况下是O(1),最坏是O(n)/O(log n),因此TreeMap在查询和读写性能上略逊于HashMap。如果业务不要求有序和区间查找key,优先使用性能更高的HashMap,如果需要按照区间查询key或者要求key有序则选择TreeMap。
TreeMap的方法源码在这里不再详细介绍,因为其查询和增删改操作都是标准的红黑树算法,这属于经典的数据结构的内容。
Set
Set是无序单列集合,其最大特点是元素不能重复,当插入重复元素时set会自动忽略,根据这一特性Set一般用于需要去重的场景,set的主要实现类有HashSet、TreeSet。LinkedHashSet使用场景较少,暂时不做讲解。
HashSet
HashSet是使用哈希表实现的无序集合,其底层封装了一个HashMap,key就是Set中的元素,所有key的value固定设置为一个特殊值present,所以其底层实现和HashMap相同。
成员变量
HashSet由于底层基于HashMap实现,所以几乎所有成员变量都已经被HashMap封装好了。其主要成员变量就是一个HashMap和一个特殊值作为HashMap中的value。
transient HashMap<E,Object> map;

// 哨兵对象,当向Set插入元素时,元素会作为key,PRESENT会作为value一起添加到HashMap中。
static final Object PRESENT = new Object();
构造方法
HashSey的构造方法也很简单,主要工作就是根据传入的初始容量和负载因子初始化HashMap。
// 无参构造,直接调用HashMap的无参构造
public HashSet() {
    map = new HashMap<>();
}

// 带有初始容量和负载因子的构造方法
public HashSet(int initialCapacity, float loadFactor) {
    map = new HashMap<>(initialCapacity, loadFactor);
}
核心方法
HashSet的核心方法只有添加等基础增删改查操作,复杂操作比如扩容等都已经在HashMap中封装好了。在add()方法内部就是向HashMap添加了一个key为e,value为PRESENT的键值对。
public boolean add(E e) {
    return map.put(e, PRESENT)==null;
}
简单来说HashSet就可以理解成value为固定值的HashMap,因为Set的主要用处就是去重以及快速查找元素,这正是HashMap所擅长的,因此HashSet选择了直接封装一个HashMap对外使用。
TreeSet
TreeSet和HashSet一样,底层也是封装了一个Map,从其名字就可以看出其封装的是TreeMap,所有操作也都是基于TreeMap提供的方法进行封装。其结构和HashSet几乎完全一样。
成员变量
private transient NavigableMap<E,Object> m;

// 哨兵节点,所有key的统一value。
private static final Object PRESENT = new Object();
构造方法
与HashSet不同,由于TreeSet没有容量和负载因子,所以TreeSet主要使用的构造方法是无参构造方法,其会将map初始化一个空的TreeMap。
public TreeSet() {
    this(new TreeMap<>());
}
核心方法
核心方法就是添加元素的add()方法,和HashSet类似。
public boolean add(E e) {
    return m.put(e, PRESENT)==null;
}
HashSet和TreeSet的区别可以完全参考HashMap和TreeMap的区别:TreeSet支持范围查找和按顺序元素,但是TreeMap的查询和操作效率是低于HashSet的,因此只有业务需要对元素排序或根据范围查找元素时才会选择TreeSet。