框架篇,现在企业项目开发几乎没有不使用框架的,所以框架相关的知识在实际开发过程中一定是非常重要的,而Java框架生态中最著名的就是Spring系列的框架了,所以本章主要讲解Spring、Spring MVC、Spring boot的相关知识,另外还会对目前主流的持久层框架mybatis进行讲解。
Spring 的单例 bean是线程安全的吗
首先需要明确的是,绝大多数bean都是单例的,只有我们在类声明上显示添加
@Scope("prototype")注解,该bean才会变成多例bean,如果不添加该注解或者使用@Scope("singleton"),那么默认该bean就是单例的
spring 的单例bean是否线程安全,取决于其内部是否包含可变的成员变量。
如果是bean中包含可变的成员变量,即bean是有状态的,那么是线程不安全的,存在并发修改问题,可以通过加锁或多例bean解决。
如果bean中不包含可变的成员变量,即这个bean是无状态的,那么则是线程安全的。
Spring AOP原理
AOP,全称面向切面编程,用于将那些与业务无关,但却对多个公共对象产生影响的公共逻辑和行为,抽取并封装为一个可重用的模块,这个模块被称为切面(Aspect),主要作用是减少系统中的重复代码,降低了模块间的耦合度,同时提高了系统的可维护性。
AOP常见的使用场景:
记录操作日志:日志记录并不是某个模块特有的,很多业务都需要记录日志,AOP使得我们不需要在每个方法中都编写日志记录相关代码,而是定义一个切面,将日志记录逻辑封装到切面中即可。
缓存处理:缓存也是很多个service中都需要使用的,可以将缓存处理的逻辑也封装到切面中,降低耦合
Spring 内置的事务处理。
Spring中的事务是如何实现的
有时候我们需要保证一段代码的执行具有原子性,即将多行代码封装在一个事务中,Spring支持编程式事务和声明式事务两种方式
编程式事务控制:需要使用
TransactionTemplate来进行实现,对业务代码有侵入性,一般不在项目中使用。声明式事务控制:声明式事务通过Spring AOP实现。其本质是通过AOP,对方法进行拦截,在目标方法开始前开启事务,在方法执行结束后根据执行情况选择提交或回滚事务。具体方法是在需要保证原子性的方法上添加
@Transactional注解,即可使该方法原子性地执行。
Spring中事务失效的场景
在某些场景下编码不当可能会导致Spring的事务失效,而事务一旦失效,意味着数据的安全性就没有保证了,所以我们需要了解spring中常见的事务失效的场景。
@Transactional的原理是通过Spring AOP动态代理实现的,只有经过代理对象调用方法,事务才会生效,很多事务失效的场景都是因为没有走代理对象。
下面介绍几种常见的事务失效的原因:
异常捕获处理。Spring实现事务的切面逻辑是通过try-catch捕获异常,如果捕获到异常才会回滚事务,如果我们在方法内部使用try-catch捕获到了异常从而导致异常没有向上抛出,那么就不会触发事务回滚逻辑,从而导致事务失效。
解决方法:在方法内部的catch块中的逻辑处理完之后再向上throw一个
RuntimeException。
对象没有被Spring 容器管理。对象通过new关键字手动创造,没有进入Spring容器管理,无法创建代理对象,事务失效。
方法内部使用this调用其他方法。方法内部如果使用
this.method()调用其他方法,调用的是原始对象的方法而不是代理对象的对应方法,如果该方法执行出错,则无法回滚。解决方法:调用代理对象的对应方法,使用
AopContext.currentProxy()获取到代理对象,调用代理对象的方法。
方法不是public权限。Spring AOP只能拦截public方法,非public无法生成代理增强。
抛出受检异常。Spring事务的增强逻辑中,默认catch运行时异常和error,不会捕获受检异常,因此如果方法抛出受检异常,也会导致事务失效。
解决方法:配置
@Transactional的rollbackFor属性,指定回滚的异常类型。例如@Transactional(rollbackFor = Exception.class)表示抛出所有类型的异常都会回滚。
Spring bean的生命周期
Spring容器在进行实例化时,会根xml配置文件或@Component注解将类信息封装成BeanDefinition对象,Spring容器会根据BeanDefinition来创建bean对象,BeanDefinition中有很多用来描述bean的属性。
有了BeanDefinition之后我们就可以通过其中的方法获取到bean的构造方法并执行创建bean。bean创建完成之后执行依赖注入,在使用@Autowired或@Resource注解的地方将依赖注入到对应的字段上。
当依赖注入完成之后,就要执行初始化方法了,如果类实现了InitializingBean接口,或者定义了init方法,则会在这个阶段执行这些初始化方法。
到此为止bean的创建和初始化就结束了,可以看到bean的创建和初始化是分开的,因此需要注意它们之间的先后顺序,在开发中我们可能遇到使用的bean在该阶段还没有初始化完成的问题,因此需要注意bean的初始化顺序。
bean使用完成之后,在销毁之前,如果我们定义了preDestroy方法,那么该方法会在bean销毁之前执行,一般会做一些资源释放的工作,执行完之后bean就会被彻底销毁了。
下面是一张bean的详细生命周期示意图,包含了很多刚才没有提到的阶段。
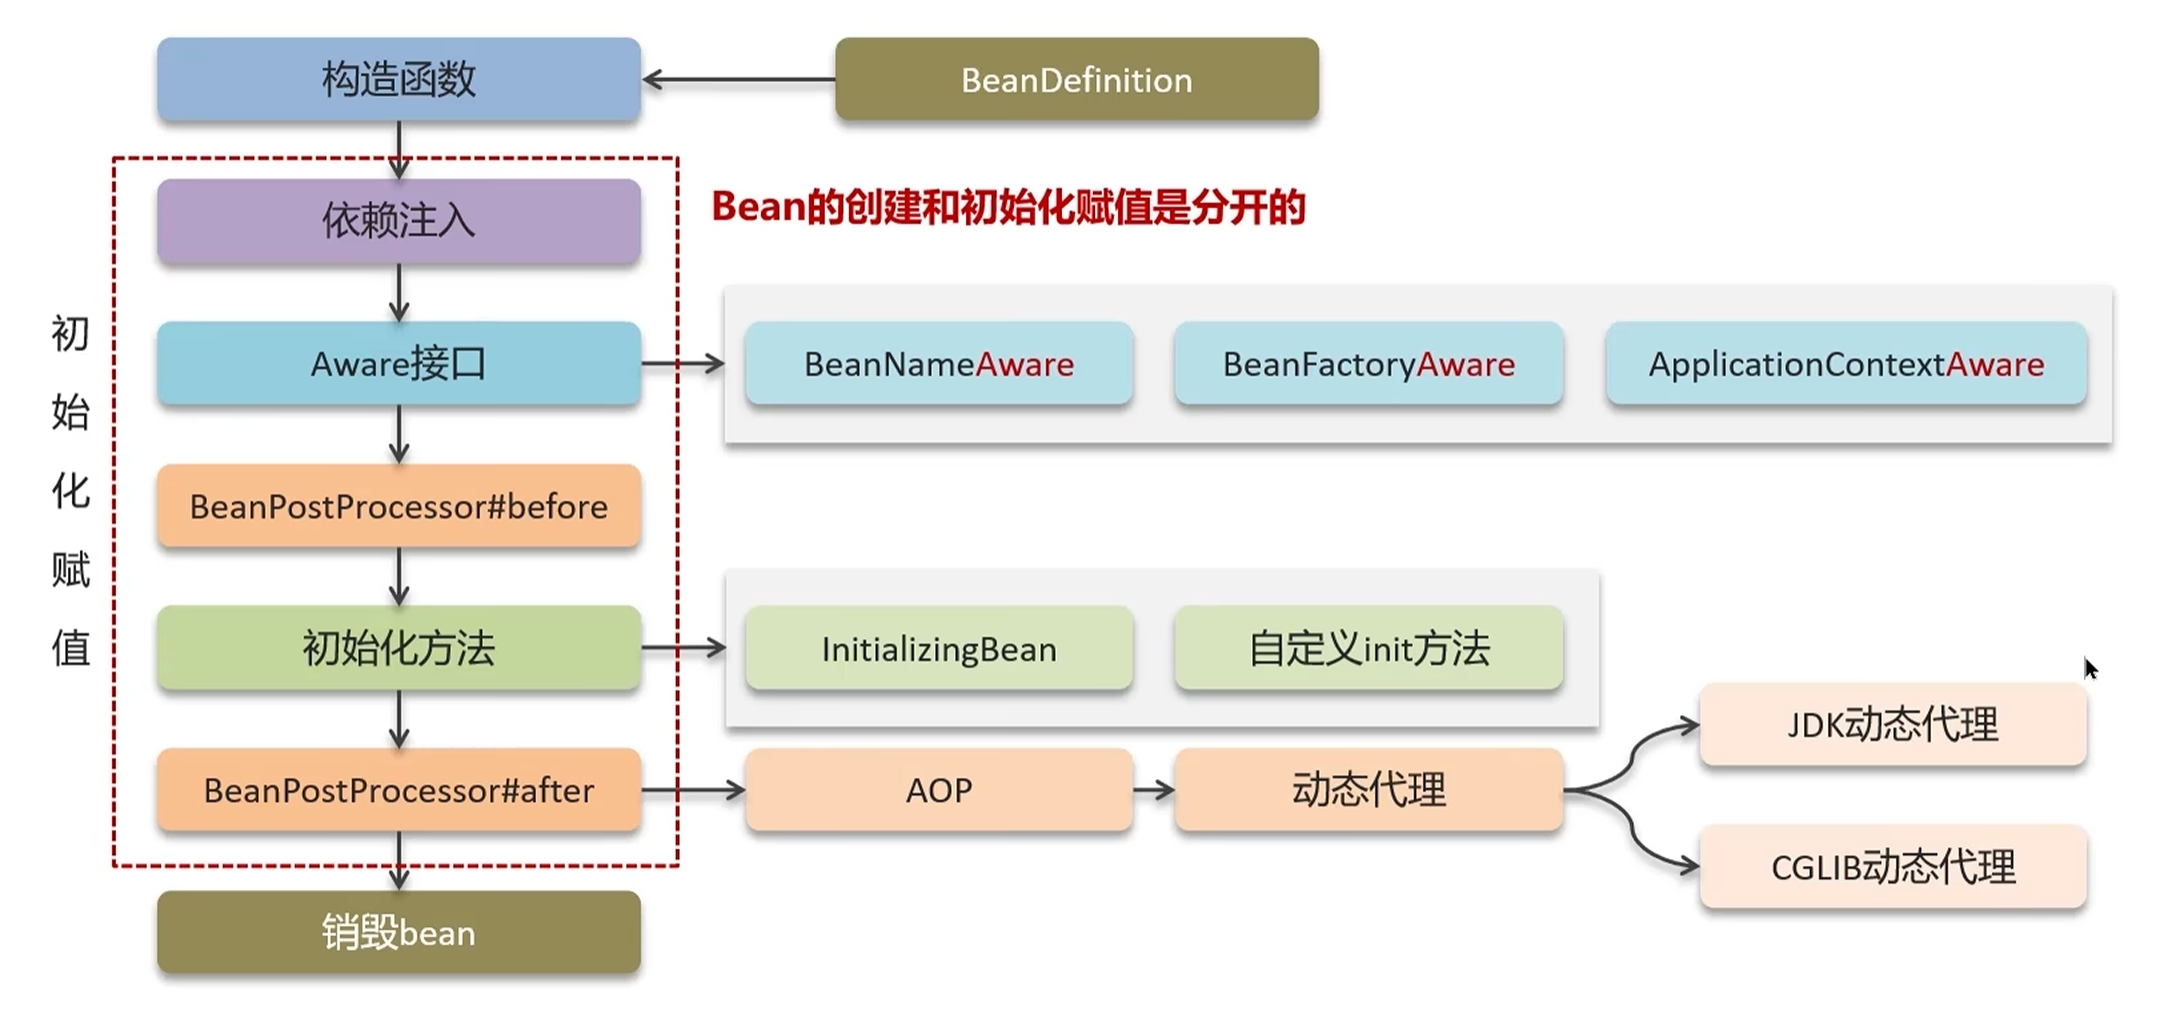
因此Spring bean的整个生命周期可以总结为:
通过
BeanDefinition获取bean的定义信息。调用构造函数实例化bean。
对bean中的实例字段进行依赖注入。
处理Aware接口(
BeanNameAware、BeanFactoryAware、ApplicationContextAware)。bean的后置处理器
BeanPostProcessor-前置。初始化方法(
InitializingBean、init-method)。bean的后置处理器
BeanPostProcessor-后置。Spring AOP的动态代理增强就是在这个阶段进行的,会生成代理对象对方法进行环绕增强。销毁bean。
Spring循环依赖
假设我们在类A中引用了B对象,而在B类中又引用了A对象,现在AB两个类都被注册为了单例bean,那么此时便会出现循环依赖问题。假设A的bean执行完了构造方法,需要进行依赖注入,此时在容器中查找B的bean对象,发现还没有创建,于是开始创建B的bean,显然B的bean在依赖注入的时候也会因为A的bean没有初始化完成而阻塞,这就导致了A和B的bean都无法创建,这就是循环依赖。
Spring通过三级缓存解决循环依赖问题,在Spring中有一个单实例对象注册器,其简化代码如下:
 //单实例对象注册器
 public class DefaultSingletonBeanRegistry extends SimpleAliasRegistry implements SingletonBeanRegistry{
     private static final int SUPPRESSED_EXCEPTIONS_LIMIT = 100;
     private final Map<String, Object> singletonObjects = new ConcurrentHashMap(256);        //一级缓存
     private final Map<String, Object> earlySingletonObjects = new ConcurrentHashMap(16);    //二级缓存
     private final Map<String, ObjectFactory<?>> singletonFactories = new HashMap(16);       //三级缓存
 }
一级缓存:
singletonObjects,单例池,缓存已经经历了完整的声明周期,已经完成初始化的bean对象。二级缓存:
earlySingletonObjects,缓存早期的bean对象,生命周期还没有执行完,通常是已经执行完构造函数,但之后的初始化逻辑还没有执行完毕。三级缓存:
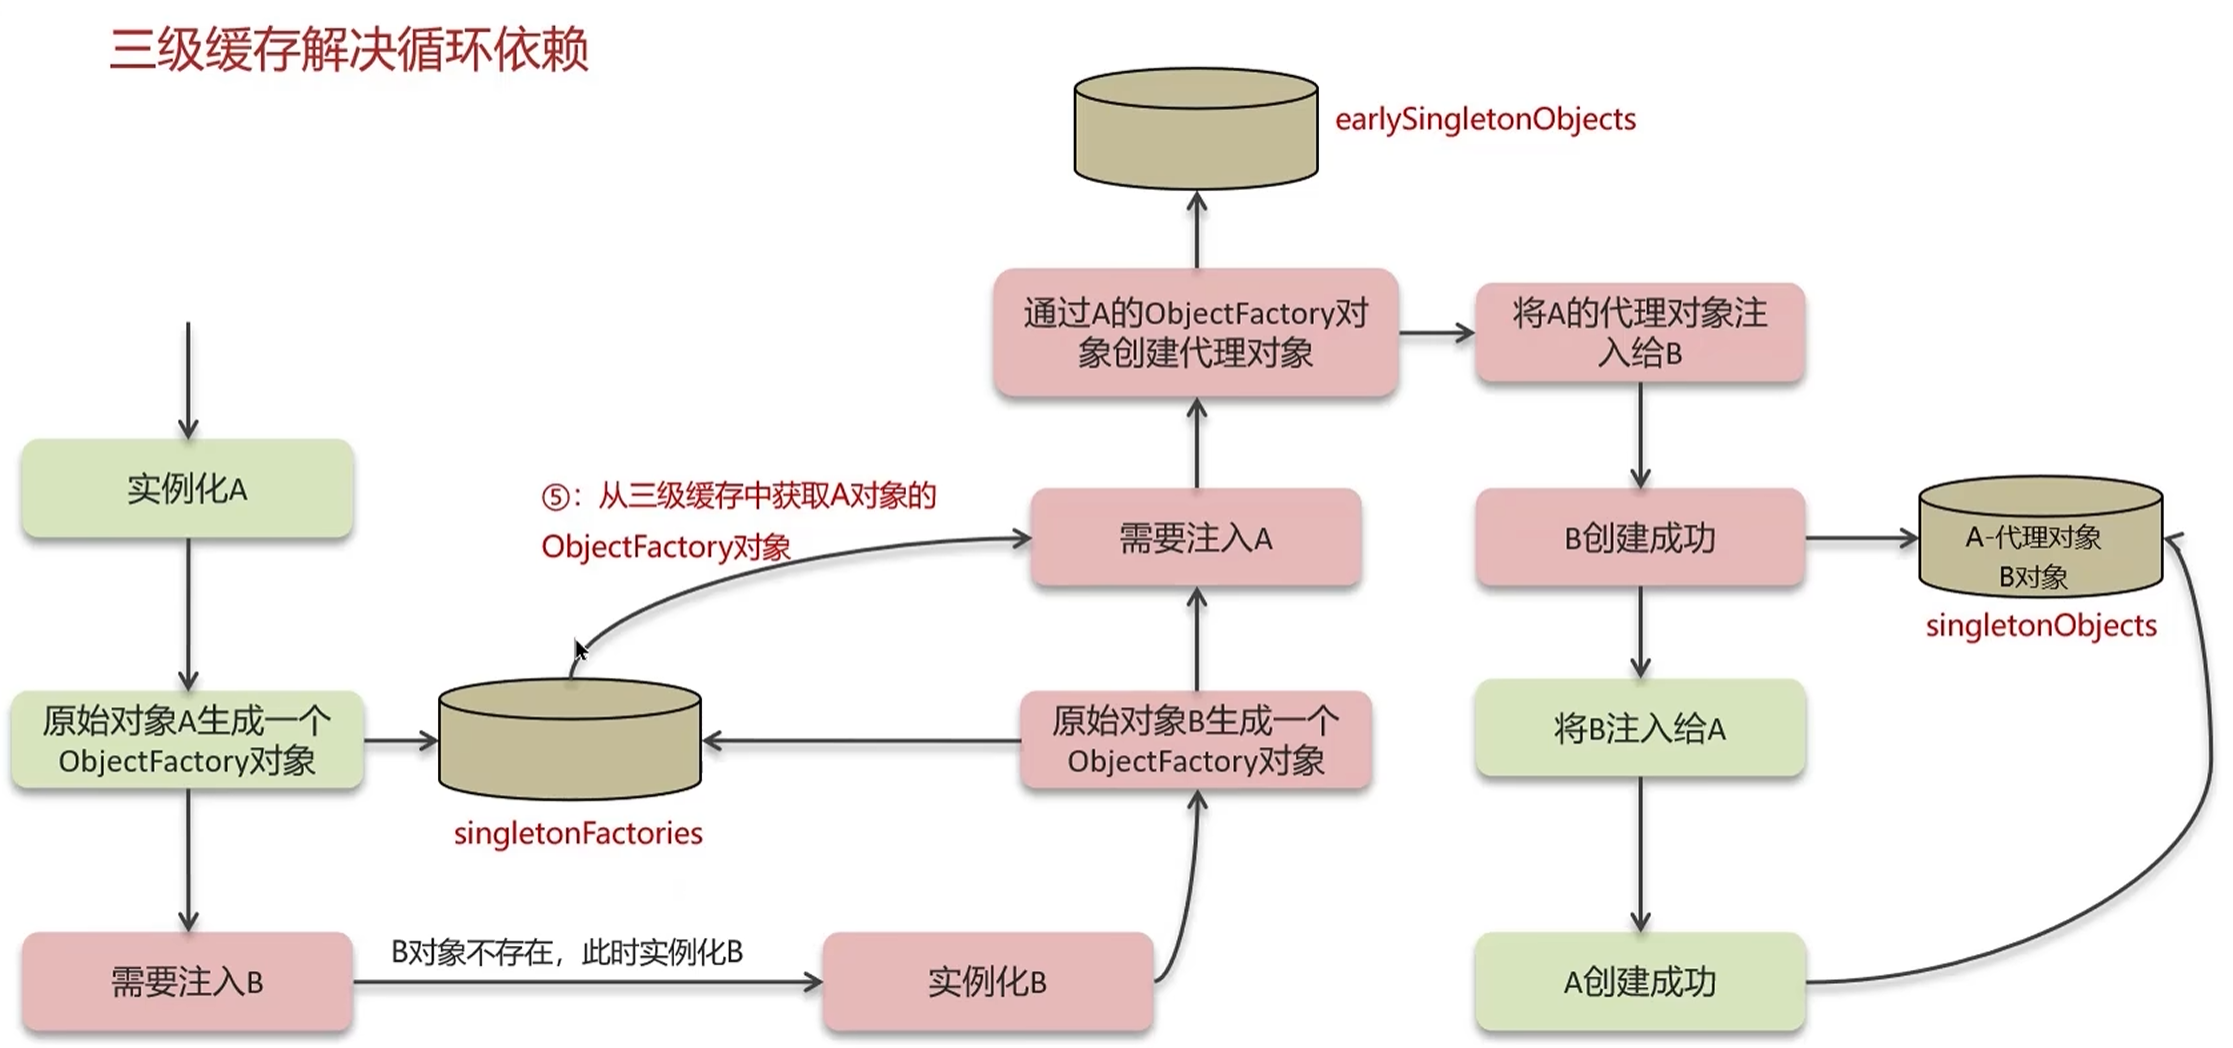
singletonFactories,缓存ObjectFactory,表示对象工厂,用来创建对象的。
为什么需要三级缓存
一级缓存的作用是保证bean在容器中只存在一个实例,即实现singleton scope,解决不了循环依赖。
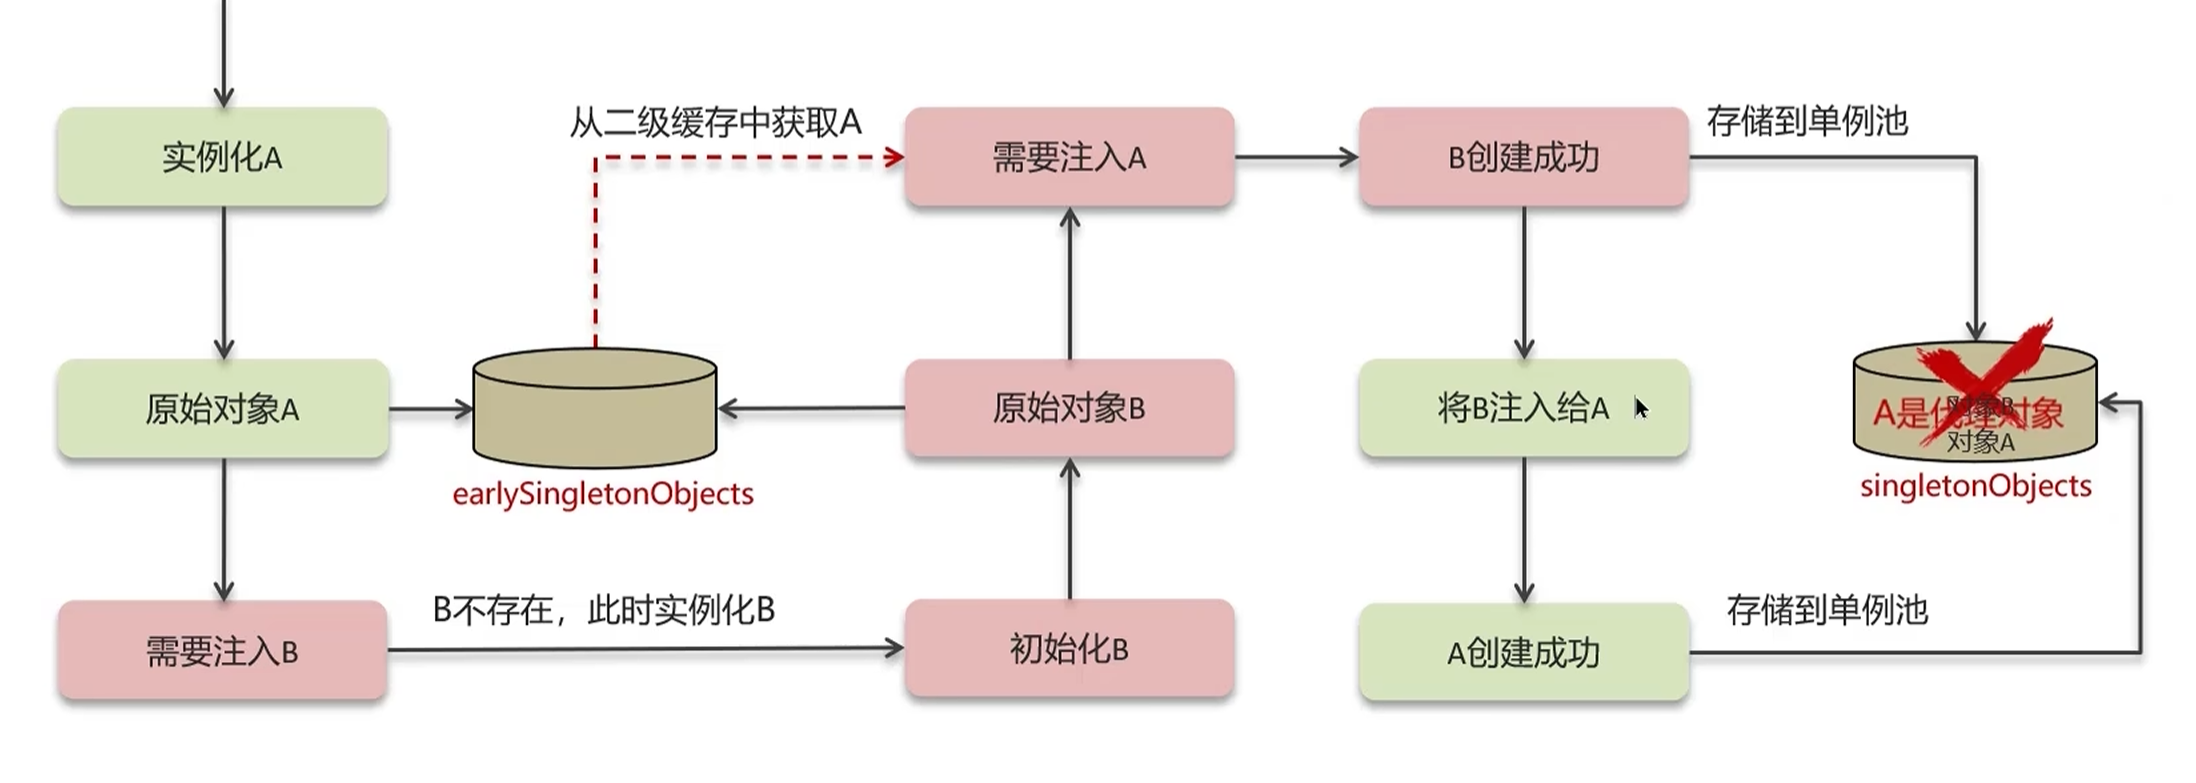
那么一级和二级缓存能否解决循环依赖问题呢?假设引入了二级缓存,那么在我们之前描述的情况中,当A对象需要查找B对象时,A对象会先进入二级缓存,同样B对象也会进入二级缓存,此时Spring会将还未初始化完成的A对象的引用注入到B对象中,这样B对象就已经初始化完成了,便可以进入一级缓存,并且注入到A对象的B字段中,然后A对象也可以进入一级缓存了。看样子一级缓存和二级缓存确实解决了循环依赖问题,事实上,一级缓存和二级缓存可以解决一般对象的循环依赖问题,但是当对象是代理对象的时候,二级缓存就不够用了,需要引入第三级缓存。
在前面的基础上我们再假设A对象需要代理增强,如果只有一级和二级缓存,A对象执行完构造函数之后放入二级缓存的是原始A对象,当B对象在二级缓存中查找A对象注入后,注入的实际上是A的原始对象,而不是代理增强对象。B填充完属性之后放入一级缓存,此时A才能注入B,并且继续走完生命周期,生成代理增强后的A。最终结果就是容器中一级缓存存放的是代理A,而B对象引用的是原始A的bean。
二级缓存生成bean流程图。
那么引入三级缓存是如何解决这个问题的呢?加入了三级缓存之后,当A对象执行完构造函数之后,会被存入一个对象工厂(ObjectFactory),该对象工厂会被存入三级缓存,当B对象需要注入A时,在一级和二级缓存中都没有查找到A,这时会去三级缓存中查找,查找到A的对象工厂便会去尝试获取A对象。对象工厂的作用就是,对外提供获取A对象的接口,在内部判断A是否需要AOP代理增强,如果需要就提前创建AOP代理对象并返回,如果不需要则直接返回原始A对象,这样一来B对象拿到了正确的A对象便可以正常完成依赖注入进入一级缓存。并且对象工厂产生对象之后会将这个半成品bean放入二级缓存,这样下次再查找A的bean时候就会先在二级缓存查找,不需要再次让对象工厂产生了,保证了bean的单例性。
Spring的三级缓存帮助我们解决了循环依赖问题,那么是否意味着开发中一定不会出现循环依赖问题呢?答案是否定的,因为我们刚才所有假设的前提都是bean已经创建出来,那么如果bean在构造函数中就循环依赖了,Spring的三级缓存便束手无策了,因为构造函数在bean的声明周期中是最先执行的,此时bean甚至还没有创建出来,三级缓存也就没用了,此时解决办法便是在构造方法的对应bean参数前添加一个@Lazy懒加载注解,意思是当前先跳过该bean的依赖注入,什么时候需要这个bean了再进行创建或在缓存中寻找并注入。
Spring MVC的执行流程
Spring MVC在早期 JSP流行的时候和现代前后端分离开发的执行流程是不同的,因为现在JSP基本已经淘汰,所以这里主要讲解基于前后端分离的Spring MVC执行流程。
用户发出的请求到达前端控制器
DispatcherServlet。DispatcherServlet收到请求调用HandlerMapping(处理器映射器,作用:以键值对的形式存储所有URL及其对应的方法,根据请求的URL找到对应的方法)。HandlerMapping找到具体的处理器,生成处理器对象及处理器拦截器(如果有),再一起返回给DispatcherServlet。DispatcherServlet调用HandlerAdapter(处理器适配器,作用:对不同类型的Handler进统一处理,并将结果返回,体现了适配器模式)。HandlerAdapter根据不同类型的Handler执行不同的逻辑,调用不同的处理器(Handler/Controller)并将执行结果返回。如果方法上添加了
@ResponseBody,则通过HttpMessageConverter将响应结果转换为JSON并作为响应体响应。
Spring Boot自动配置原理
Spring Boot的最大亮点和优势就是自动配置,提到Spring Boot就不得不提到它的自动配置原理了。
Spring Boot的自动配置原理如下:
在Spring Boot项目的引导类上有一个注解
@SpringBootApplication,该注解对三个注解进行了封装,分别是:@SpringBootConfiguration:标记当前类是一个配置类@EnableAutoConfiguration:开启Spring Boot自动配置。@ComponentScan:组件扫描,自动发现并注册bean,默认扫描范围是启动类所在包及其子包。
其中
@EnableAutoConfiguration注解是实现自动配置的核心注解,该注解通过@Import注解导入对应的配置选择器。其内部会读取该项目和项目引用的jar包的classpath路径下的META-INF/spring.factories文件中所配置的类的全类名,在这些配置类中所定义的bean会根据条件注解所指定的条件来判断是否需要将其注入到spring容器中。条件判断会有类似
@ConditionalOnClass这样的注解,如果存在对应类的class文件则会加载该配置类,并且将配置类中所有的bean放入spring容器中使用。
Spring框架的常见注解有哪些
Spring框架中的注解分为三类:Spring Framework中的注解、Spring MVC中的注解、Spring Boot中的注解。
Spring Framework常见注解。
Spring MVC常见注解。
Spring Boot常见注解
这部分主要还是会在实际开发中使用,一般面试不太作为考察内容。
Mybatis执行流程
mybatis是现在Java开发中最流行的持久层框架,所以学习该框架的底层原理是很有必要的,这里先介绍一下mybatis的执行流程。
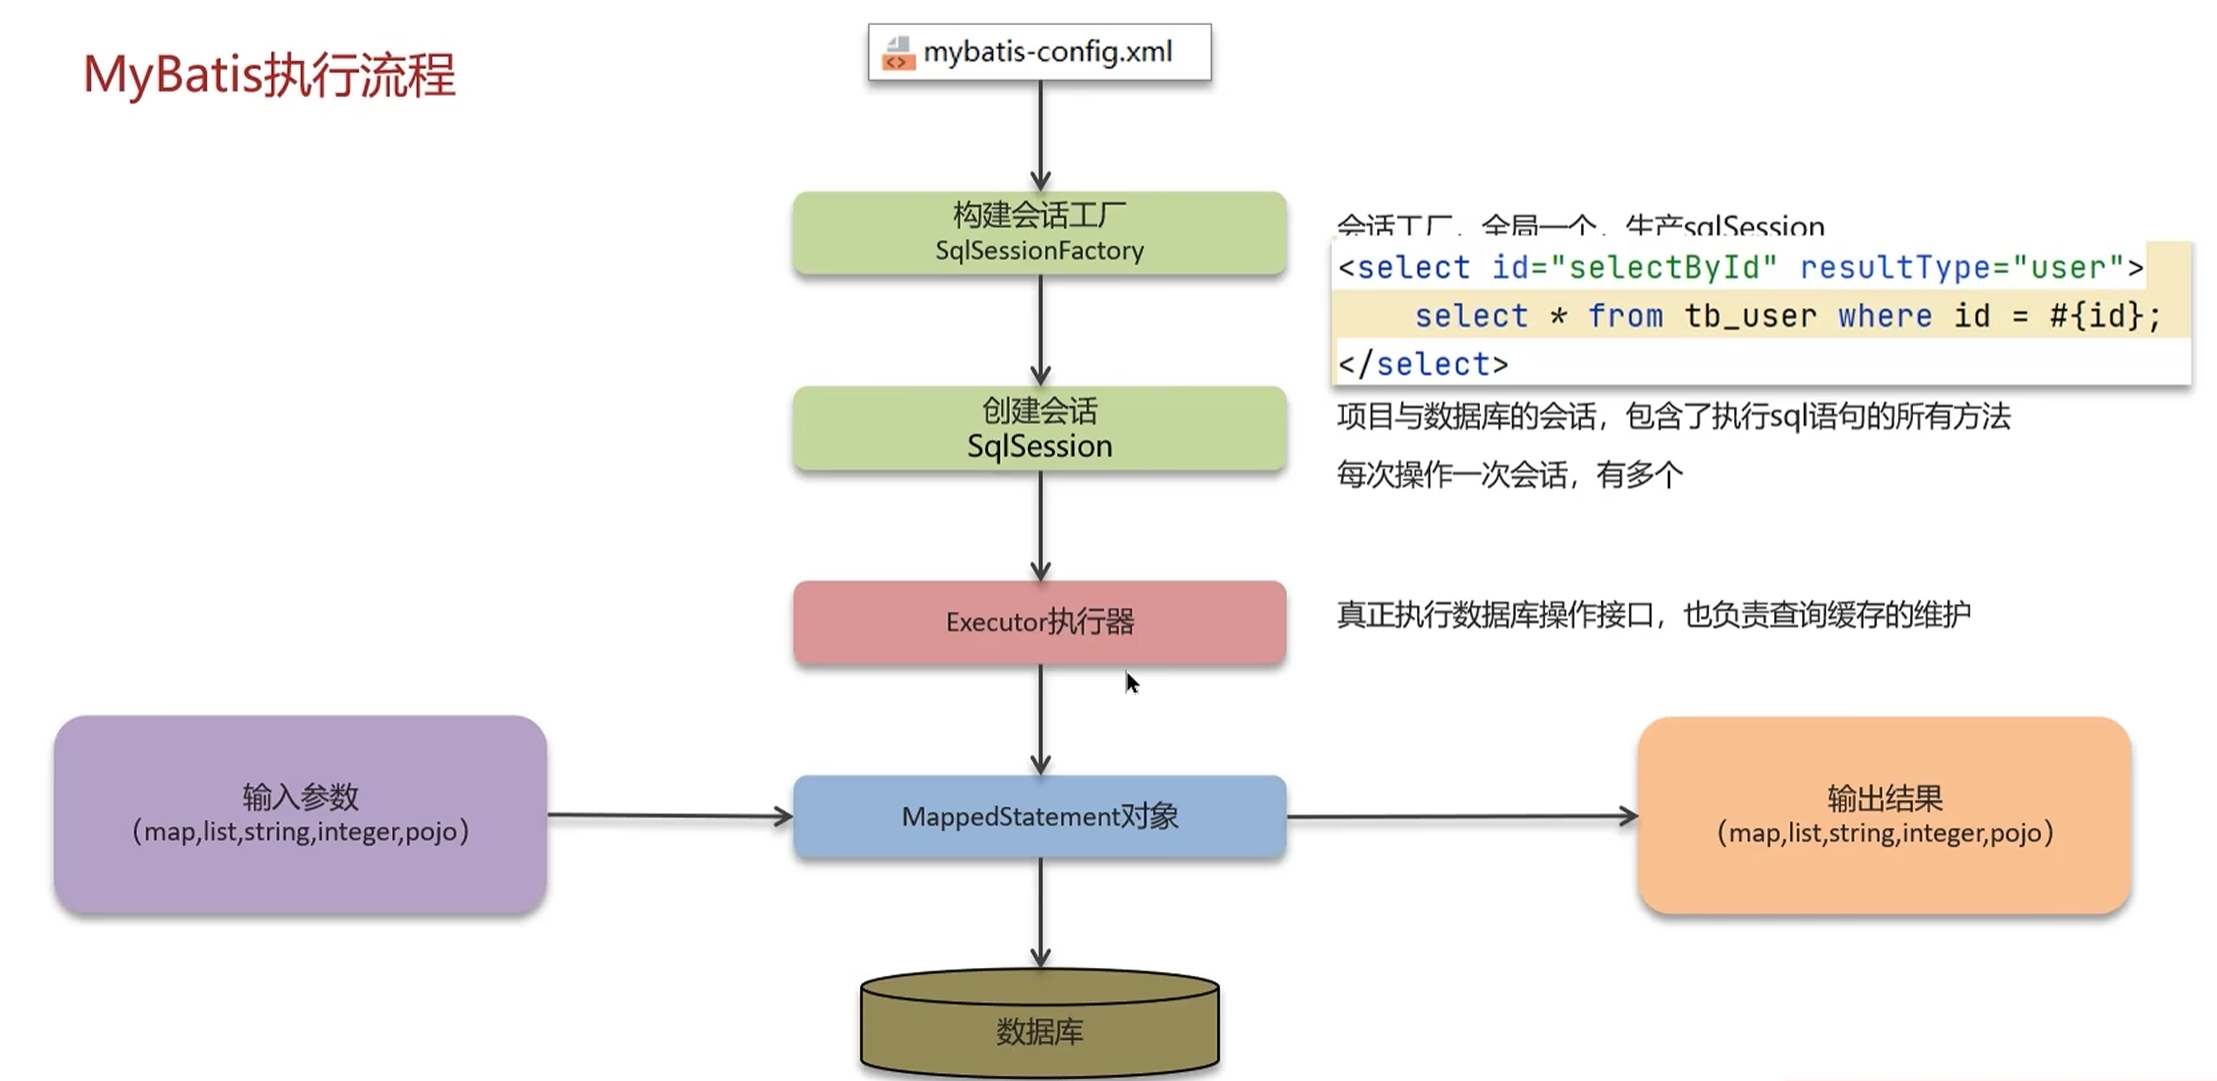
mybatis在启动该之后会先读取mybatis-config.xml配置文件,这份配置文件包含了数据库的连接信息以及表映射文件的存储位置。根据这份配置文件便可以配置mybatis的运行环境。
创建会话工厂
SessionFactory,主要作用是创建SqlSession(包含了执行SQL语句的所有方法)。操作数据库的接口,
Executor执行器,同时负责查询缓存的维护。Executor的执行方法中有一个MapperStatement类型的参数,这个参数封装了这次数据库操作的信息,包括执行的SQL语句,映射文件的标签,标签信息等。将输入参数映射为MySQL对应的参数类型。
操作完成数据库之后,将数据库返回结果映射成Java对象。
Mybatis的延迟加载
mybatis的延迟加载是指在关联查询时,先不查询关联表,只有在需要获取关联表的数据时才执行查询关联表的SQL。
例如现在有一张用户表,用户表关联了订单表, 即一个用户可以有多个订单,当我们在业务中查询用户信息时,因为用户信息中包含订单列表。如果不开启延迟加载,那么调用mapper接口时会执行两条SQL语句,同时查询用户表和订单表;如果开启了延迟加载,那么查询订单表的SQL暂时不会执行,只有当我们调用user.getOrderList()时获取用户订单列表时才会执行查询订单的SQL。
在xml映射文件中的对应标签上添加fetchType="lazy"属性可以开启该字段的延迟加载。
示例xml映射文件
<!DOCTYPE mapper
PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN"
"http://mybatis.org/dtd/mybatis-3-mapper.dtd">
<mapper namespace="com.itheima.mapper.UserMapper">
<resultMap id="userResultMap" type="user" autoMapping="true">
<id property="id" column="id"></id>
<result property="username" column="username"></result>
<result property="password" column="password"></result>
<result property="gender" column="gender"></result>
<result property="addr" column="addr"></result>
<collection property="orderList" ofType="order"
select="com.itheima.mapper.OrderMapper.findByUid"
column="id" fetchType="lazy">
</collection>
</resultMap>
<select id="selectById" resultMap="userResultMap">
select *
from tb_user
where id = #{id}
</select>
</mapper>延迟加载的原理:
当执行SQL查询时,mybatis不会返回原始对象,而是使用CGLIB创建代理对象返回,包裹真实对象。
当调用目标方法时吗,进入拦截器的invoke方法,发现目标值为null,执行SQL查询。
获取数据以后调用setter方法设置值,之后再次调用getter方法就可以正常获取值了。
Mybatis一级缓存和二级缓存
Mybatis为了提高查询同一信息的效率,设计了多级缓存,如果持续查询重复数据的话,直接返回缓存中的结果就可以了。
一级缓存:基于
PerpetualCache的HashMap本地缓存,其作用域为SqlSession,当Session进行flush或者close之后,该Session中的Cache就将清空,一级缓存默认是开启的。二级缓存:
namepsace和mapper级别,不依赖于SqlSession,也就是每个mapper映射文件(每个mapper类)拥有一个独立的缓存,默认也是采用PerpetualCache的HashMap缓存。默认关闭,需要手动开启。
使用注意事项:
对于缓存数据更新机制,当某一级缓存中进行了增删改操作后,默认该缓存中的所有select的缓存都会被清空。
二级缓存需要缓存的数据需要实现Serializable接口。
只有会话提交或者关闭之后,一级缓存中的数据才会转移到二级缓存中。