微服务篇。本篇主要介绍微服务相关内容,现在Java应用微服务领域的框架主要就是Spring Cloud,但是本章不会过多介绍该框架的内容,因为在实习或者刚开始工作的阶段是不需要太深的微服务相关的知识的,因为每个团队负责不同的服务开发,如果需要别人 提供的服务只需要调用提供的接口就可以了,会有专门的团队协调整个微服务架构,所以本章不会介绍太多框架知识,会介绍一些微服务的业务解决方案。
Spring Cloud 五大组件分别是什么
这是对Spring Cloud最基础的内容考察。一般也不会问的很深,这道题主要是看你用没用过微服务相关组件或框架。
通常情况下Spring Cloud一般会至少包含五大组件,但有时可能会更多,但是以下五个组件是所有微服务项目都必须存在的:
Eureka:注册中心,负责服务注册发现。如果项目使用的是Spring Cloud Alibaba,那么可以使用nacos作为注册中心,同时nacos也可以作为项目的配置中心。
Ribbon:负载均衡。
Feign:远程调用。
Hystrix:服务熔断。如果项目使用的是Spring Cloud Alibaba,那么可以使用Sentinel进行服务保护。
Gateway:网关。
微服务限流问题
一般互联网项目需要做限流的原因有两个:一是并发量确实大,业务流量高;另一个原因是防止用户恶意刷接口(爬虫)。
限流的实现方式一般有以下几种:
为Tomcat设置最大连接数。
在Nginx层实现漏桶算法。
在网关层实现令牌桶算法。
自定义拦截器。
一般微服务项目都是有nginx和网关的,而且nginx和网关作为业务的同一入口,在这里设计限流算法也是最合理的,所以本节重点讲解网关的令牌桶算法和nginx的漏桶算法。
nginx限流算法实现
nginx的限流方式有两种,一种是基于漏桶算法实现,形式是控制速率;另一种是控制并发连接数。
漏桶算法
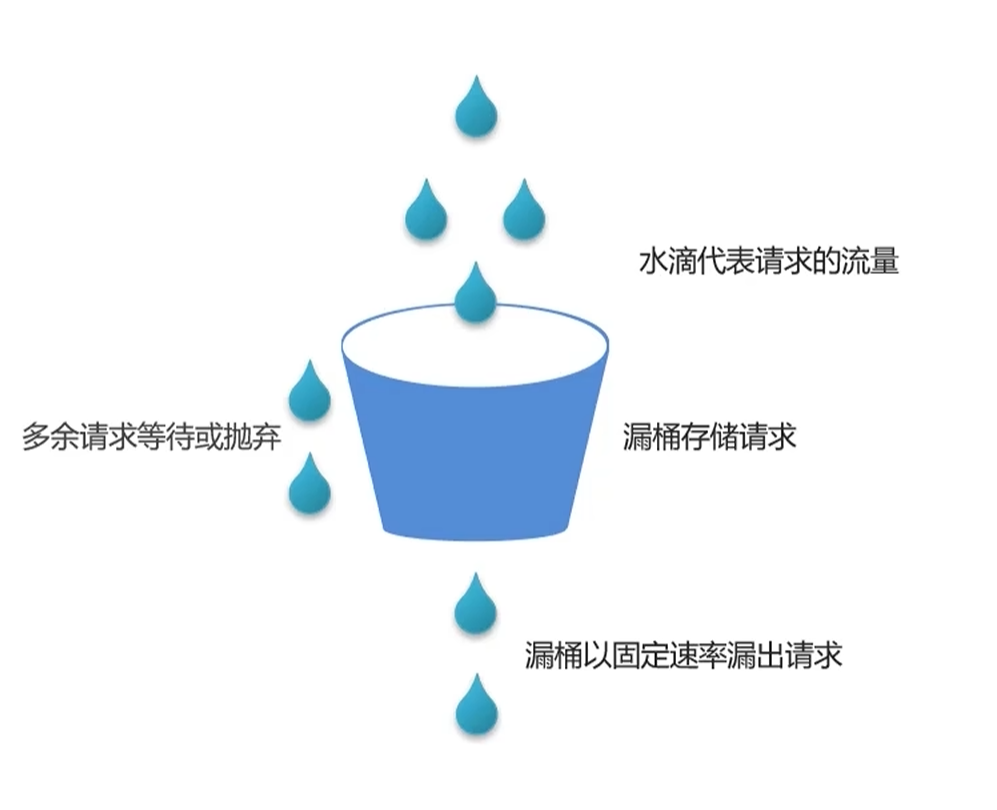
漏桶算法可以理解为有一个漏桶,其中可以盛一定量的水,其中水代表请求的流量,桶表示一个限流器,桶中的水以固定速率露出请求,起到一个缓冲的作用。但是桶也是有容量的,如果容量过多桶装不下,那么多余的请求会被丢弃(快速失败)或等待。
漏桶算法可以实现让请求以固定速率到达后端服务,即使流量突增也不会造成业务压力过大。
最大并发连接数
可以在nginx.conf文件中配置每个ip的最大连接数和并发连接总数。
网关限流算法
在Spring Cloud gateway中支持局部过滤器RequestRateLimiter来做限流,使用的是令牌桶算法。
令牌桶算法原理:在网关中以固定速率生成令牌,令牌会存入到令牌桶中,到达的请求需要先获取令牌才可以进入处理流程,如果桶中暂时没有令牌则需要等待或被抛弃。桶满后令牌会暂停生成。
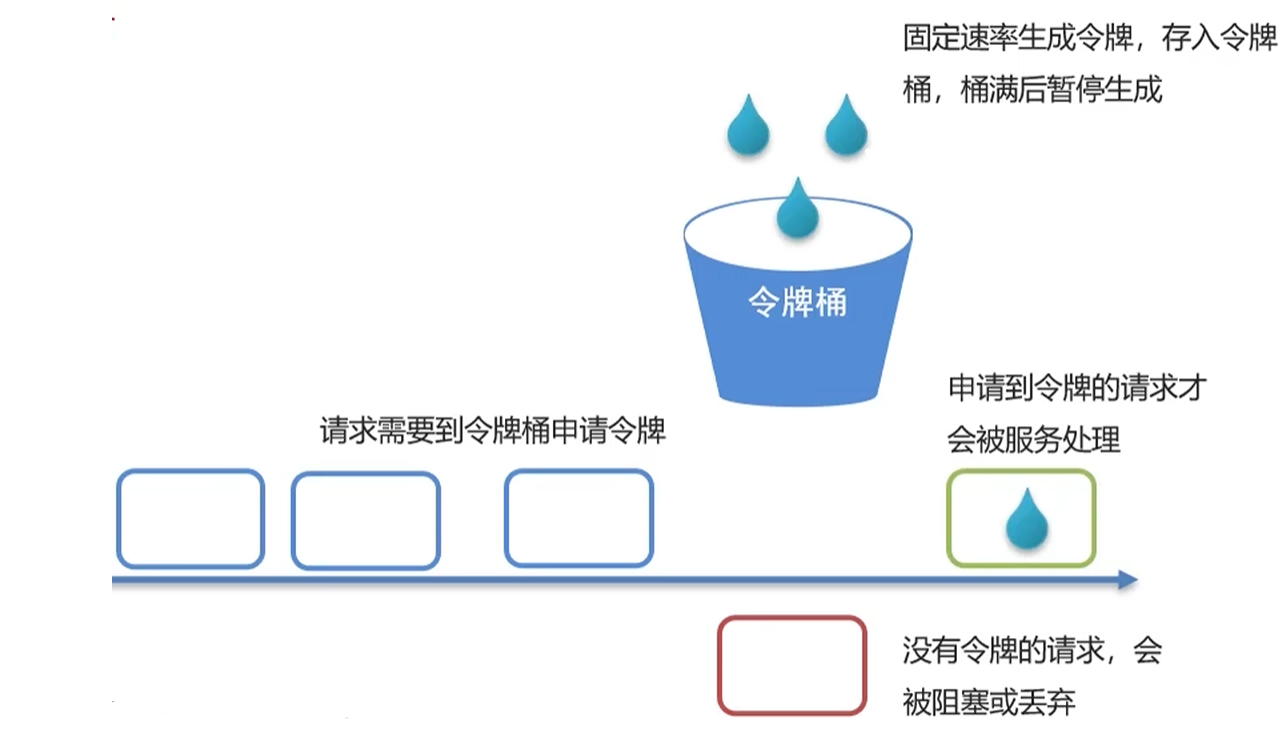
令牌桶算法和漏桶算法的区别:漏桶算法永远以固定的速率通过请求,即使流量暴增也还是会保持预定的速率漏出请求。而令牌桶算法由于会将令牌预先存放在桶中,因此当流量突增时可能会导致令牌被洗劫一空,到达后端的请求也会迎来峰值。
另外在gateway中也支持根据ip或路径进行限流,可以设置令牌生产速率,以及令牌桶最大容量来限制并发数。
分布式系统理论
分布式系统理论无关真是项目,是所有分布式系统通用的理论基础,这里主要介绍两个最著名的分布式系统理论:CAP和BASE。
CAP
CAP定理认为,衡量一个分布式系统主要有三个指标:
Consistency(一致性):用户访问分布式系统中的任意一个节点,得到的数据必须一致。
Availability(可用性):用户访问集群中的任意健康节点,都必须能得到响应,而不是超时或拒绝。
Partition tolerance(分区容错性):在集群出现分区(因为网络故障或者其他原因导致分布式系统中的部分节点与其他节点失去联系,形成独立分区)时,整个系统也要持续地对外提供服务。
一个分布式系统无法同时满足这三个指标,最多同时满足两个,即AP、CP或AC。这个结论就叫做CAP定理。
CAP定理原理:
分布式系统节点之间通过网络连接,所以分区是必然存在的。
如果优先保证可用性,要求持续对外提供服务,那么在形成网络分区的时候,由于数据无法同步,则必然无法保证一致性。
如果优先保证一致性,那么分区节点必然需要等待和集群的数据同步,此时分区节点就处于不可用状态,即无法保证可用性。
因此当分区出现时,可用性(A)和一致性(C)无法同时满足。
CAP理论告诉我们:分区是必然存在的,因此分区容错性(P)是一定要保证的,所以在设计分布式系统时,需要在AP和CP之间做取舍,这个需要根据业务需求选择。例如业务如果是金融等强一致性场景,那么会优先考虑CP。
BASE
BASE理论是对CAP的一种解决思路,包含三个思想:
Basically Available(基本可用):分布式系统在出现故障时,允许牺牲部分可用性,保证核心可用。
Soft State(软状态):在一定时间内,允许出现中间状态,比如短暂的不一致状态。
Eventually Consistent(最终一致性):虽然无法保证强一致性,但是在软状态结束后必须保证最终一致性。
分布式事务解决方案
在传统单体项目中,单机数据库可以依靠本地事务保证事务的原子性。然而在微服务架构中,各个服务之间可能发起远程调用,并且每个服务有自己的数据库,这就导致多个数据库之间的操作无法保证原子性,这就是分布式事务问题,即如何保证不同服务操作不同的数据库的操作的原子性。
分布式事务目前主流的解决方案有两个:Seata框架和MQ。
Seata
Seata是目前主流的微服务分布式事务中间件,主要用于解决跨服务、跨数据库场景下的数据一致性问题,提供了分布式事务解决能力。
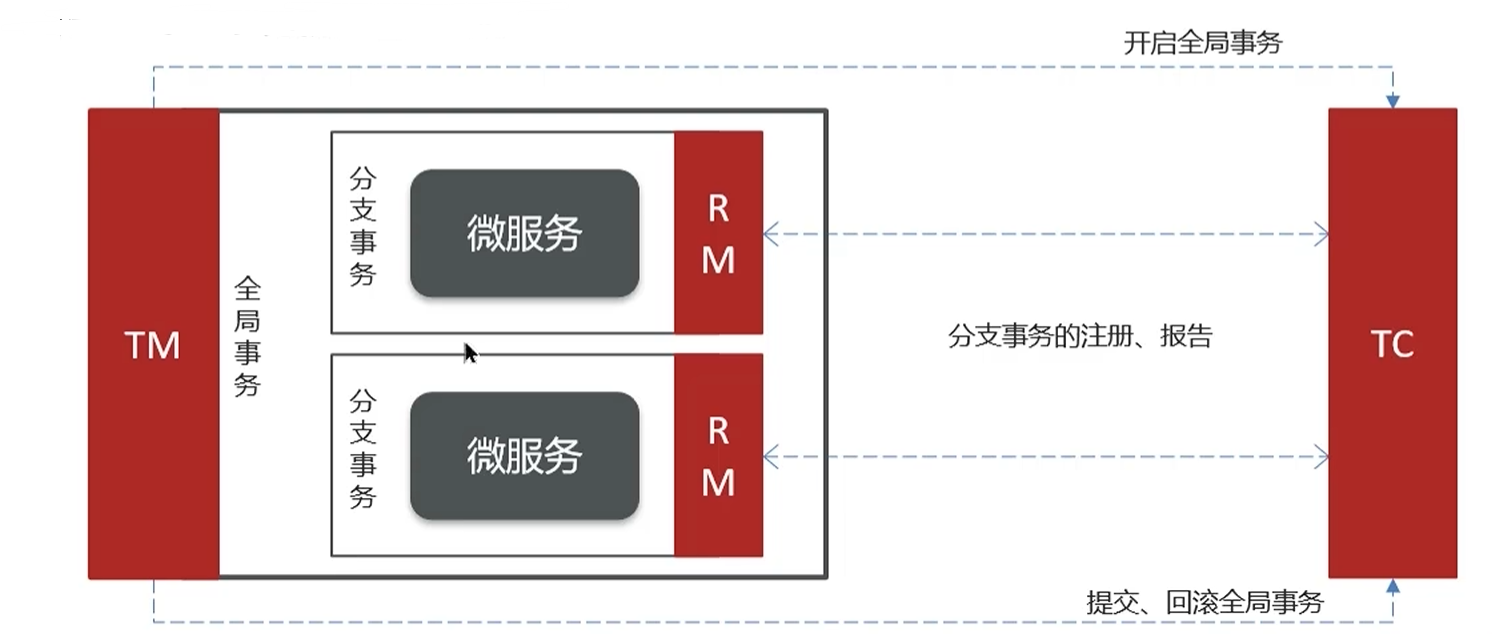
Seata事务管理中有三个重要的角色:
TC(Transaction Coordinator)- 事务协调者:维护全局和分支事务的状态,负责协调全局事务的提交或回滚。
TM(Transaction Manager)- 事务管理者:定义全局事务的范围,开启全局事务,提交或回滚全局事务。
RM(Resource Manager)- 资源管理者:管理分支事务处理的资源,与TC通信以注册分支事务以及报告分支事务的状态,驱动分支事务提交或回滚。
Seata提供了三种事务模型来解决分布式问题,分别是AT、XA、TCC三种模式。
XA模式
XA模式执行流程:
TM开启全局事务,并通知各RM开启自己的分支事务。
RM向TC注册分支事务。
RM执行分支事务,执行完成之后向TC报告事务状态。
TM请求提交或回滚全局事务。
TC检查各分支事务状态,决定提交/回滚全局事务,并通知各个分支事务。
XA模式执行流程图
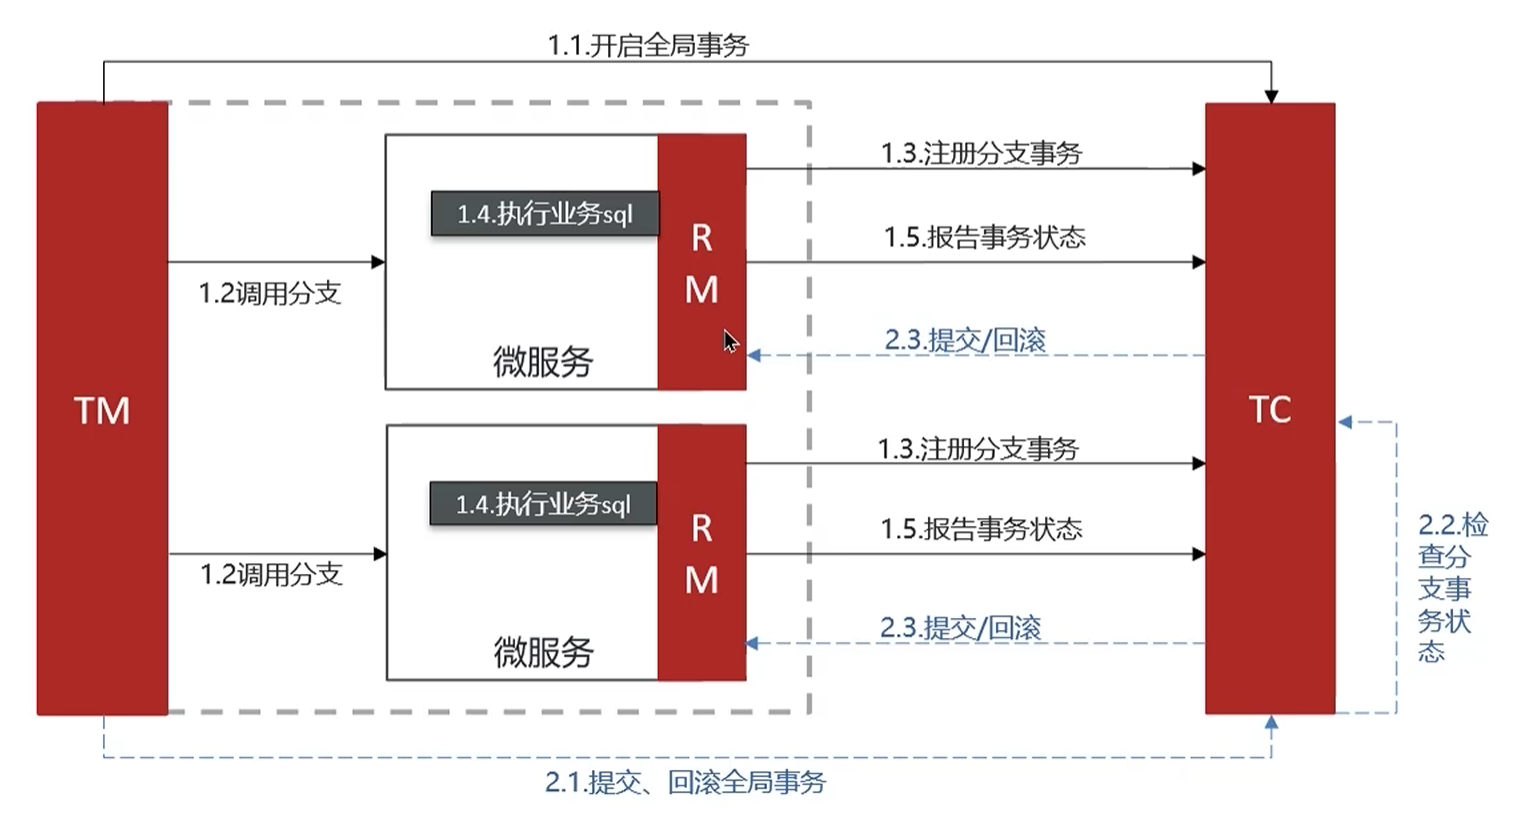
可以看到XA模式是基于CP思想实现的,因为各个RM执行完事务之后不能提交,必须等待TC下达指令,从完成事务到TC下达命令期间RM不会释放已经锁定的资源,这就牺牲了部分可用性,但是保证了一致性,即用户不会看到中间状态。
AT模式
AT模式执行流程:
TM开启全局事务,并通知各RM开启分支事务。
RM注册分支事务,执行各自的事务并提交,在这期间RM会记录更新前后的快照到undo log,事务执行完后向TC报告事务状态。
TM请求提交或回滚全局事务。
TC根据各分支事务状态决定提交/回滚全局事务并通知各RM。
如果是提及全局事务,那么RM则会删除自己的undo log;如果全局事务需要回滚,RM则会根据undo log中的更新快照恢复数据。
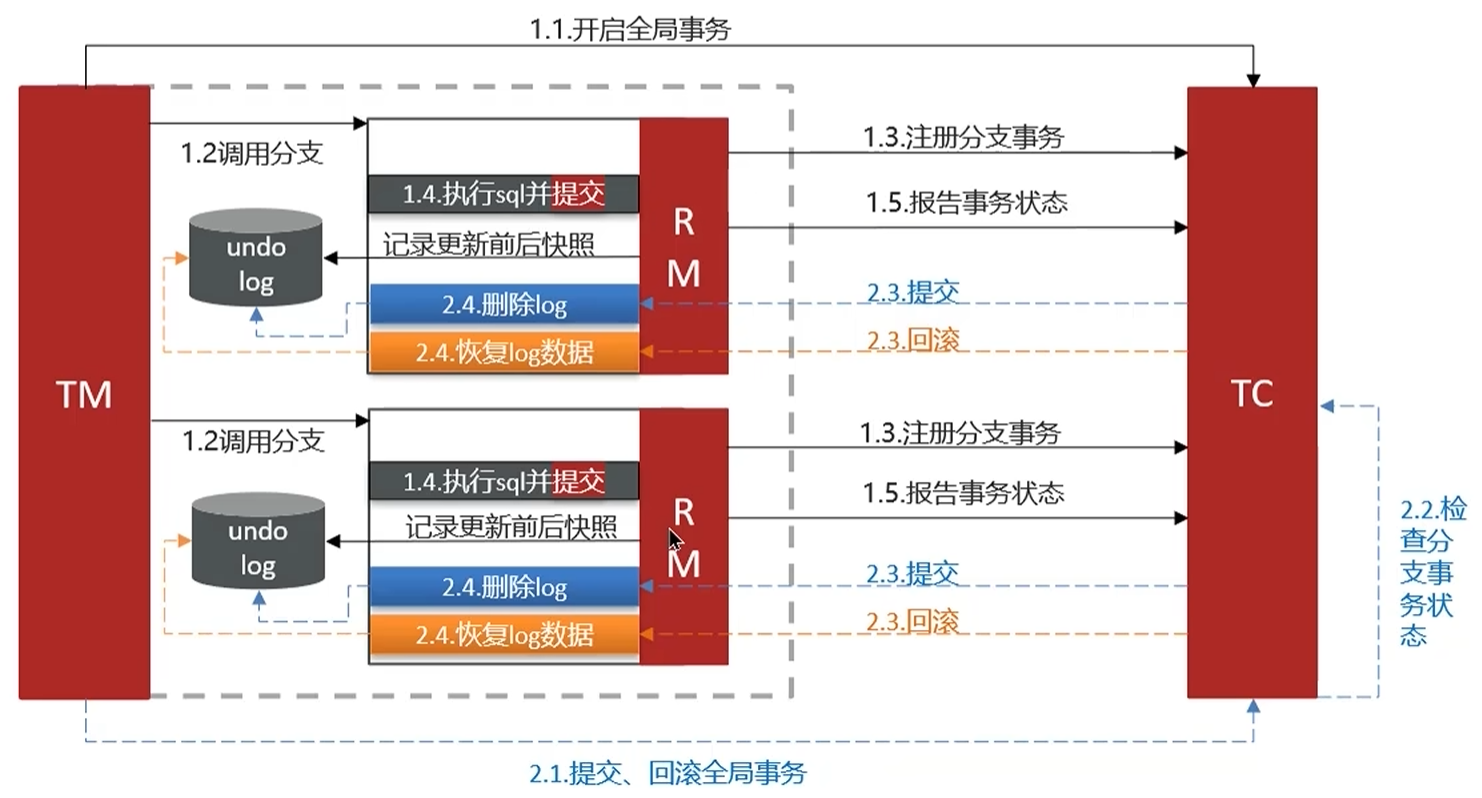
相比XA模式,AT模式则更加注重可用性,从而牺牲了部分一致性,每个RM在执行完自己的事务之后都会直接提交,释放自己的资源,保证可用性,但是代价是在这期间如果有用户查询的话会查询到中间状态。
TCC模式
TCC(Try-Confirm-Cancel)是另一种事务模型,其中Try表示资源的检测和预留,Confirm表示完成资源操作业务,要求Try成功则Confirm一定成功,Cancel表示预留资源释放,可以理解为Try的反向操作。
TCC模式执行流程:
TM开启全局事务。并通知RM执行各自的分支事务。
RM开启并注册分支事务之后不会真的执行事务操作,而是预留执行该事务需要操作的资源。
RM预留资源完成后向TC报告事务状态。
如果所有RM都可以成功预留出资源,那么则执行Confirm,通知RM开始执行对资源的操作;如果有一个RM无法预留出足够的资源,则通知其他RM将资源交还回去,即执行Cancel操作。
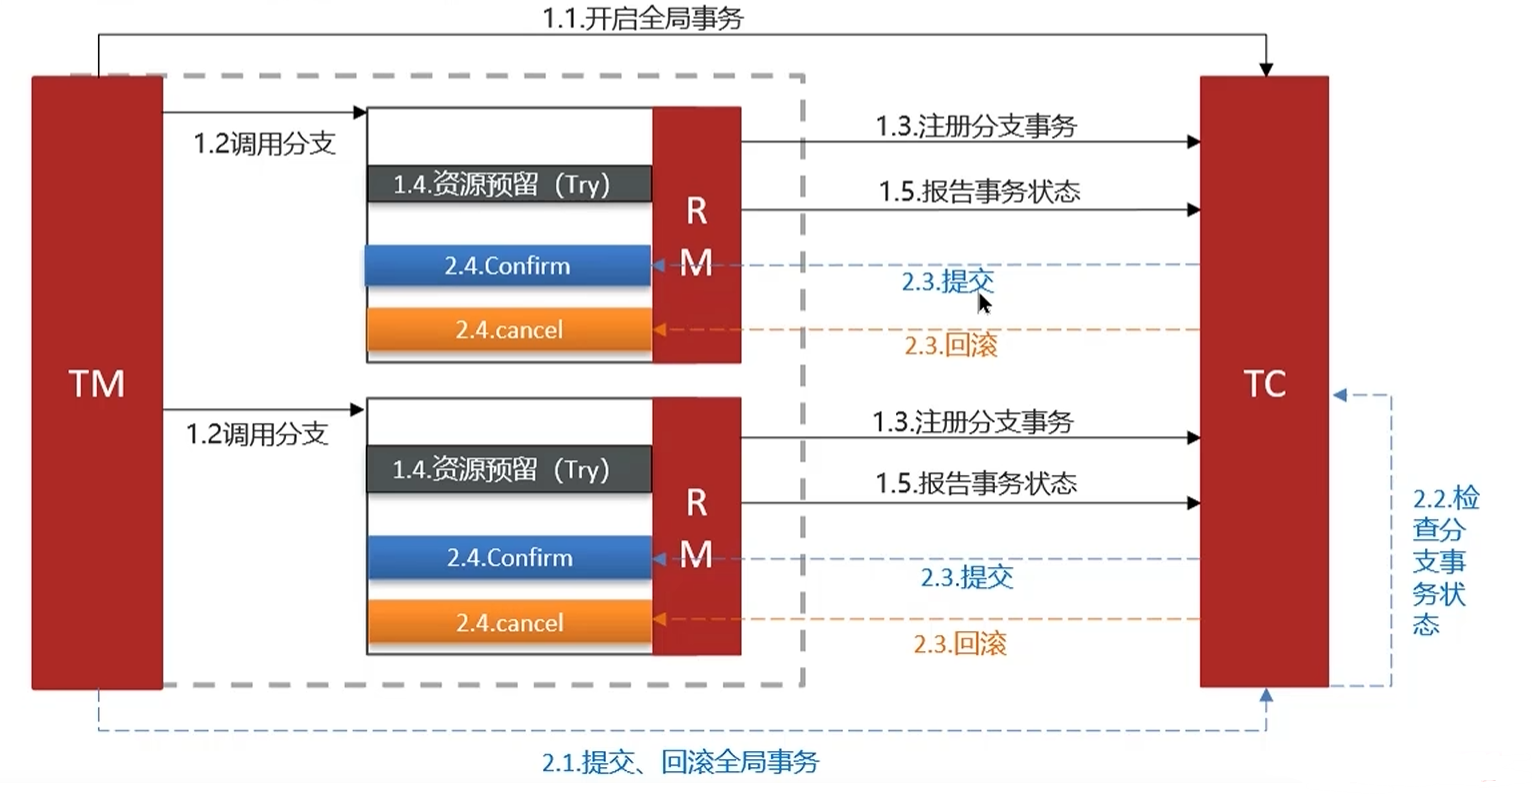
TCC模式也是基于CP思想实现的,但是其try、confirm、cancel操作都需要在业务代码中自己实现,对业务侵入性较高,因此一般不考虑使用。
MQ解决分布式事务
使用MQ解决分布式事务的思路很简单:事务执行完本地事务之后向,MQ发送一条消息,被调用服务监听这个MQ,收到消息之后在其本地执行该事务。在使用MQ解决分布式事务时需要保证向本地数据库写入和向MQ发送消息这两个操作的原子性。
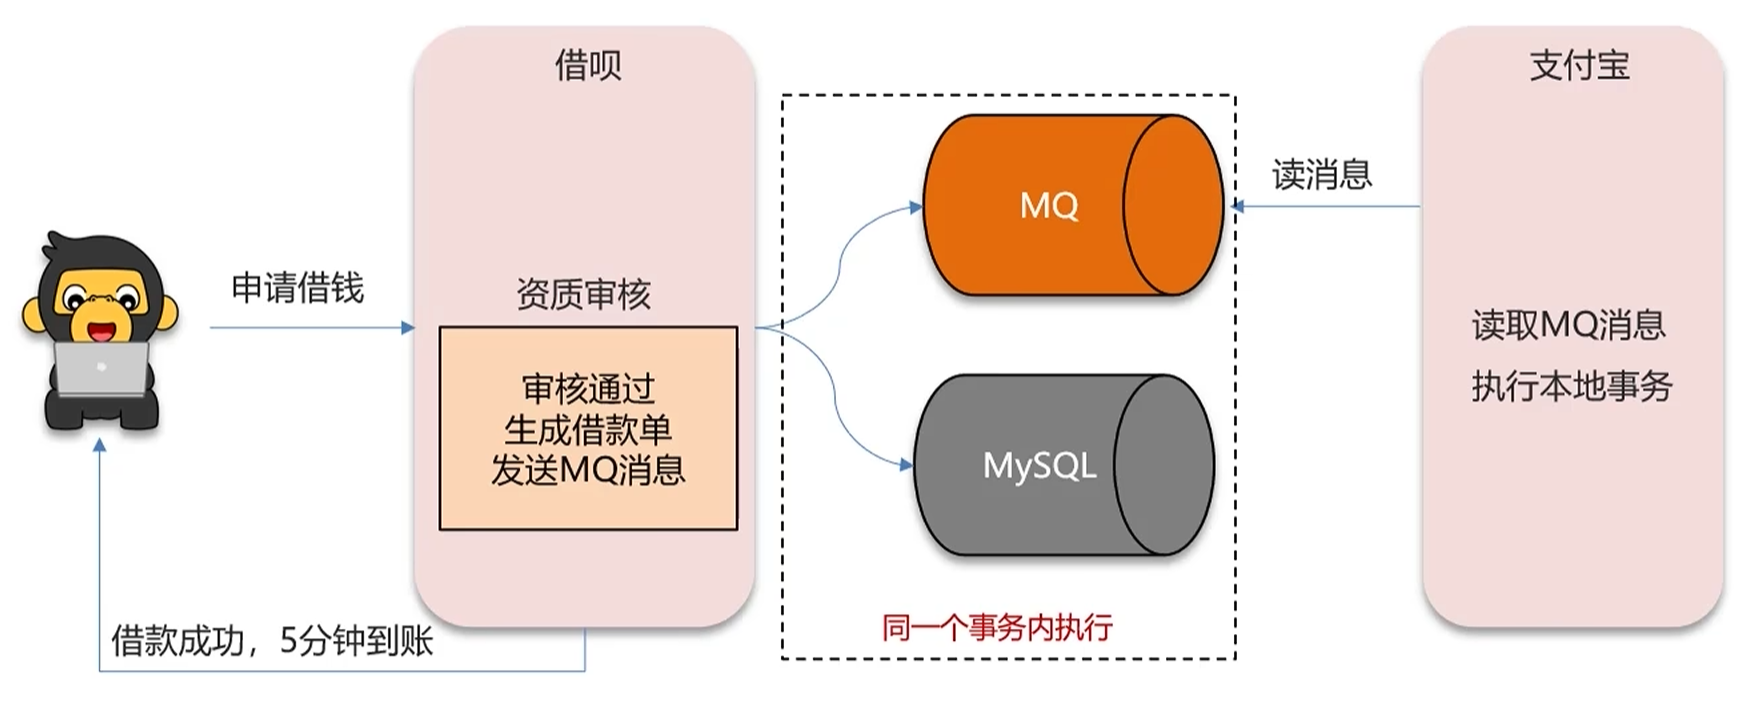
使用MQ解决分布式事务的优点是性能很好,因为是通过异步消息来实现事务原子性的。缺点是只能保证最终一致性,而且读消息的服务如果在本地执行事务时出现了异常无法进行全局事务的回滚,比如人工干预,因此使用MQ解决分布式事务也是一种不推荐的方案。
如何保证接口幂等性
接口的幂等性是指多次调用方法或者接口不会改变业务状态,可以保证多次调用同一接口和单次调用的效果是相同的。
需要幂等的场景很常见,例如用户因为网络波动重复点击,MQ消息重复,应用超时重试机制等。
从RESTful API的角度来分析请求的幂等性:
GET:查询操作,天然幂等。
POST:新增操作,请求一次和请求多次的结果是不同的,不是幂等的。
PUT:修改操作,如果是以绝对值更新,则是幂等的;如果是增量更新,则不是幂等的。
DELETE:删除操作,根据唯一值删除,是天然幂等的。
保证接口幂等性一般有如下几种方案:
数据库唯一索引:如果数据除了主键之外还有存在唯一索引,则可以借助这个唯一索引来实现业务幂等性。例如订单号是订单的唯一索引,则可以在业务层指定订单号之后插入数据,如果出现唯一键重复异常则可以捕获并认为已经插入成功。但是这种方式只能解决新增接口的幂等性,修改接口的幂等性无法保证。
Token + Redis:前端在提交前先向后端申请一个全局唯一token并存入redis,提交业务时携带token,服务端校验redis中的token,如果存在则删除;不存在则说明已经有相同的请求拿到token并执行了,当前请求可以直接返回失败结果。
分布式锁:实现很简单,就是在相应的逻辑前后加一个分布式锁即可。如果加锁失败直接返回错误结果,同时要控制锁的粒度,因为当前线程持有锁的时候其他线程不可以执行业务。不过由于这种方式性能很差,一般不考虑用这种方式解决幂等性。