并发编程篇,本章主要讲解有关并发编程的部分,项目在生产环境中面对的都是多线程环境,多线程环境和单线程环境是有很大不同的,代码质量的高低主要就体现在面对并发环境的安全性,一个高质量的代码会把并发带来的问题降到最低,因此有关并发编程的知识也是我们必须要学习的部分。
本章的内容较多,涉及到synchronized互斥锁、volatile关键字、AQS、线程池等等并发知识。主要会围绕这些知识的底层原理和设计理念来讲解
synchronized原理
synchronized对象所采用互斥的方式实现同一时间至多只有一个进程能够持有对象锁并执行同步代码块,其他线程在尝试获取锁时,如果锁已经被持有则会阻塞。以上是synchronized的基本使用方法。
monitor
在Java中每个对象都关联了一个monitor对象,这个monitor对象是由c++实现的,由jvm提供,其结构主要包含三个对象,
Owner:表示当前持有锁的线程,只能有一个。
EntryList:存放等待获取该对象锁的线程,这些线程全部都因为无法获取到锁而阻塞。
WaitList:存放所有获得该锁之后调用
wait()方法的线程。
当一个对象尝试获取对象锁时,会先检查Owner是否为空,如果为空则尝试使用CAS将Owner替换为当前线程,替换成功表示当前线程成功获得锁,替换失败代表已经有线程抢到锁了,当前线程阻塞;如果获取锁成功,则会进入同步代码块执行代码,执行完毕后释放锁,将Owner设置为空并且唤醒EntryList中所有线程,这些线程会继续争抢锁,只有一个线程会成功获取到锁执行同步代码块。从以上过程中可以看到synchronized是非公平锁,因为它并不会按照顺序依次唤醒EntryList中的线程,而是全部唤醒并让它们争抢锁,有可能刚加入EntryList的线程直接就抢到了锁,而排队了很久的线程一直抢不到锁。
锁升级
在讲解锁升级之前,我们需要先介绍一下JVM对象的内存结构。
在 HotSpot 虚拟机中,对象在内存中的布局可以分为三块区域:对象头( Header )、实例数据( Instance Data )和对齐填充。其中实例数据存放的是非静态成员变量。对齐填充是为了让对象占用的内存大小满足8的整数倍,没有实际业务含义,只是为了内存对齐,提高 CPU 访问效率。而对象头则存放对象的元数据,包括 MarkWord 和 Klass Pointer
Klass Pointer:描述对象的具体类型,指向方法区中的Klass对象,说明这个对象属于哪个类。
MarkWord:存储对象运行时状态信息,对象不同状态下其MarkWord也会对应改变。
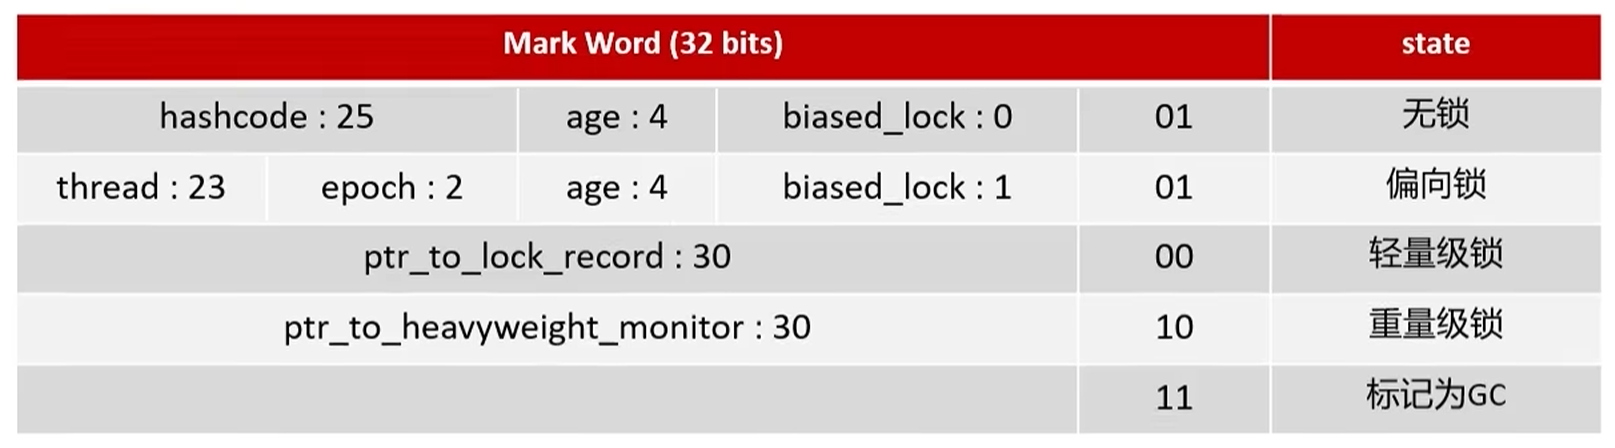
下面是 32 位 JVM 下对象的 MarkWord 的结构示意图
hashcode:代表对象的哈希值,每个对象唯一。
age:对象的分代年龄,垃圾回收时使用。
biased_lock:偏向锁标识,由于无锁和偏向锁的锁标志位都是01,所以需要另一位来区分无锁和偏向锁状态。
thread:偏向锁偏向的线程id。
epoch:偏向时间戳,作用是降低撤销偏向锁的STW开销,了解即可。
ptr_to_lock_record:轻量级锁状态下,指向lock_record的指针,占30位。
ptr_to_heavyweight_monitor:重量级锁状态下指向monitor的指针,是关联Java对象和monitor的桥梁,占30位。
我们前面讲解的 synchronized 锁的代价是很大的,其内部基于操作系统的 mutex(互斥锁) 实现,当线程获取锁失败时,会调用操作系统提供的接口来将线程挂起,这个过程会涉及内核态和用户态的切换,上下文开销是很大的,当竞争不是很激烈的时候,这种开销是不必要的,因为当抢锁线程比较少时,短暂自旋的代价是比挂起线程再唤醒的代价更小的,这就是 JVM 设计偏向锁和轻量级锁的原因。
当只有一个线程反复竞争锁时,几乎没有竞争,当第一个线程获取锁时,会使用 CAS 将当前线程 id 记录到锁对象的 MarkWord 当中,之后线程再次进入该同步块时,不需要 CAS ,直接检查 MarkWord 中记录的线程 id 和当前线程 id 一致就可以直接获得锁了。以后只要不发生竞争,这个锁就归该线程所有。
当有其他线程获取锁时,即发现 MarkWord 中记录的线程 id 和申请锁的线程 id 不一致时,说明此时已经产生了竞争,需要将偏向锁升级为轻量级锁,当线程获取轻量级锁成功时,会在栈帧中创建一个 Lock Record(锁记录对象),锁记录对象中包含两个内容,地址和 Object Reference ,将锁对象的MarkWord中的前30位( ptr_to_lock_reord )和锁记录中的Object交换(底层使用 CAS ),交换成功说明线程成功获取到轻量级锁,可以进入同步代码块了。如果 CAS 失败线程会进入短暂自旋,不断尝试 CAS 获取锁,如果自旋超过了一定次数之后依然无法成功获取锁,说明此时竞争已经比较严重了,自旋时间过长只会无意义地浪费 CPU 资源,此时应升级为重量级锁。
JMM(Java内存模型)
JMM(Java内存模型)定义了共享内存中多线程程序读写变量的行为规范,通过这些规则来规范对内存的读写操作从而保证指令的正确性。它并不是真实存在的物理模型,而是一个逻辑模型,目的是屏蔽不同操作系统和硬件差异,定义多线程下对变量的读写规范。
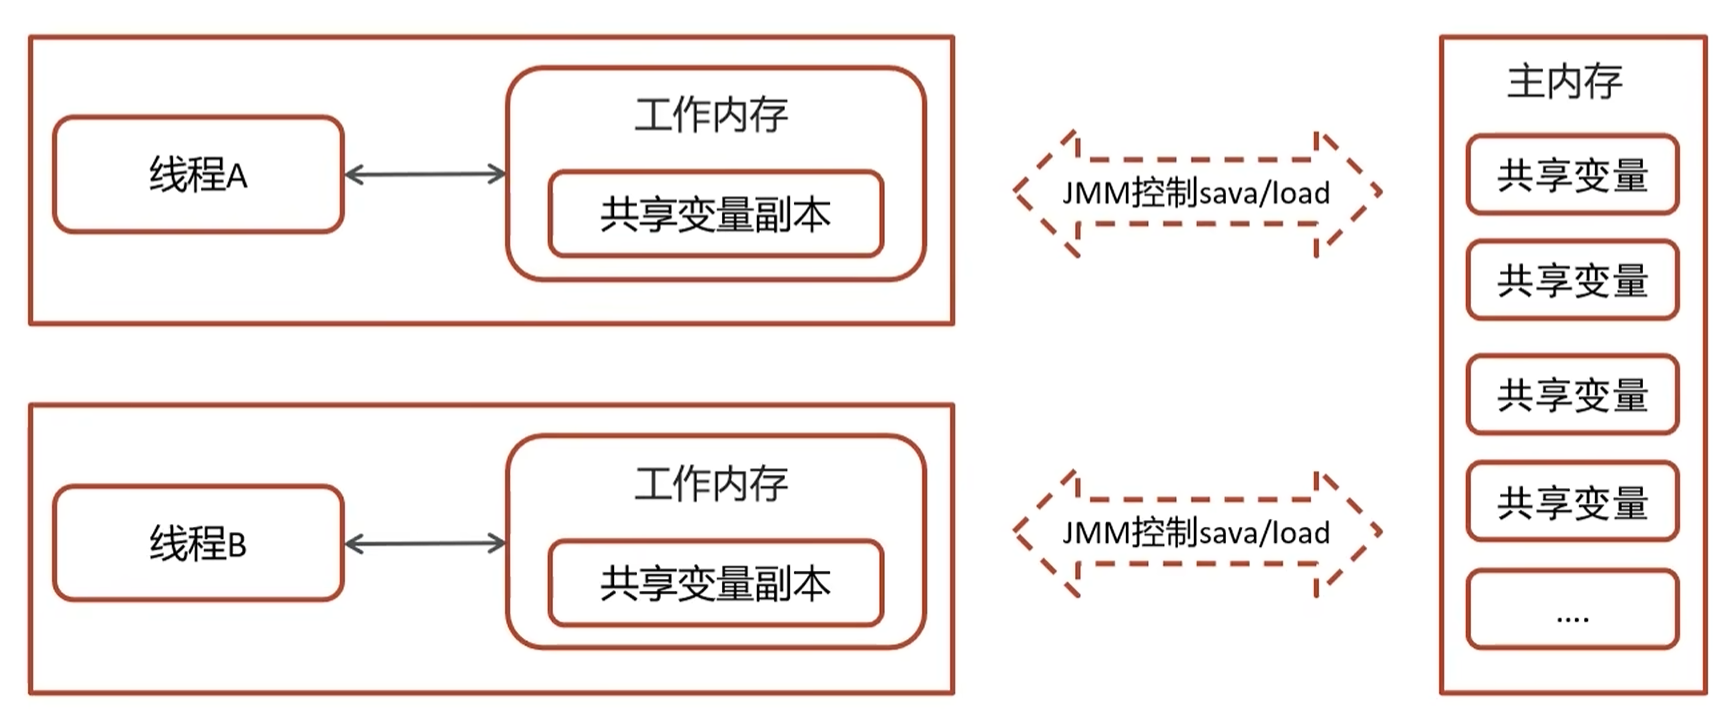
JMM将内存分为了两部分:
主内存(共享内存):所有共享变量存放于此,所有线程共享。
工作内存:每个线程私有,存放该线程使用到的共享变量副本,线程不能直接操作主内存中的变量,只能操作自己工作内存中的变量副本,然后再同步到主内存中。
因此线程与线程之间如果需要交互,必须以主内存为媒介,先操作自己的工作内存中的副本,然后将修改同步到主内存中,另一个线程再从主内存中读取共享变量以完成交互或通信。
JMM示意图
JMM主要解决了三大并发问题:可见性、原子性、有序性。
可见性:一个线程修改了变量,其他线程是否能立即看到这个修改。
原子性:一个操作要么全部完成,要么完全不执行,中间不能被打断。
有序性:CPU在不改变单线程执行语义的前提下,会改变指令执行顺序以提升性能;指令重排序在单线程环境下没有问题,但是在多线程环境下会破坏业务逻辑。
对于原子性,可以使用synchronized锁或者JDK提供的Lock实现类来保证代码的原子性,或则使用AtomicXXX等原子类来实现原子修改。
而对于可见性和有序性,可以使用volatile关键字来解决,这也是JMM的重点内容。
volatile主要有两个作用:
禁止指令重排序:通过在volatile变量的读写操作前后添加对应的屏障来禁止指令重排序。在volatile变量的写操作前会添加写屏障,阻止写操作前面的操作重排序到volatile变量写操作后面;在volatile变量的读操作后面会添加读屏障禁止读操作后面的操作重排序到volatile变量读操作的前面。通过读写屏障保证了在写volatile变量之前的操作一定全部发生了,读volatile之后的操作一定可以看到volatile变量的最新值。
保证可见性:线程完成对volatile变量的写操作后会立即刷新到主内存;读volatile变量时会直接从主内存读取,丢弃工作内存的副本。
AQS
AQS (AbstractQueuedSynchronizer),抽象队列同步器,是JUC并发包的底层基石。ReentrantLock、CountDownLatch、Semaphore、ReentrantReadWriteLock 底层全部基于 AQS 实现。AQS本身是一个抽象类,采用模板方法模式,子类继承它并重写少量方法,就可以实现一个锁/同步器。可以理解成,AQS定义了如何构建一个锁/同步器,当我们想要构建一个锁时,可以让类实现AQS,AQS中的抽象方法会指导我们如何实现。
核心成员变量
AQS主要维护了三个成员变量:
state同步状态:一个int类型变量,意义由实现类自己决定,通常表示锁或同步器的状态。例如在ReentrantLock中state = 0表示没有线程持有锁,1表示已经有线程持有锁了;CountDownLatch中state代表计数器。
CLH双向阻塞队列(FIFO):存储没有抢到锁的线程,进入队列排队,自旋或者阻塞等待锁。
Node节点:封装了等待锁的节点,存储在CLH队列中。
实现原理
当多个线程同时抢锁时,如何保证state的改变的原子性?通过CAS保证抢锁的原子性,每个线程会尝试CAS改变state,CAS成功代表抢到锁,失败则会尝试自旋。
AQS定义了完整的锁获取流程和释放流程。实现类可以重写其中调用的方法来实现不同的加锁逻辑。
AQS 获取锁完整流程(独占,ReentrantLock 非公平锁举例):
线程调用
lock(),调用 AQSacquire()acquire():先调用子类tryAcquire(),尝试修改 state 获取锁修改成功:直接拿到锁返回
修改失败:执行
addWaiter(),把当前线程包装成 Node,加入CLH 同步队列尾部
acquireQueued():节点进入队列后自旋只有当前节点的前驱是 head 节点,才有资格去尝试抢锁
抢锁失败:设置前驱节点 waitStatus=SIGNAL,调用
park()(LockSupport)阻塞当前线程
线程被
unpark ()唤醒后,继续自旋尝试获取锁。获取锁成功,把自己设置为新 head,旧 head 丢弃。
关键点:不是唤醒就一定拿到锁,唤醒只是给一次竞争机会,非公平锁新来线程还可以插队抢 state。
释放锁流程 release ():
调用子类
tryRelease(),state 减 1;可重入锁直到 state=0 才算真正释放。state 释放完毕,找到 head 的后继节点,如果后继不为 null,调用
unpark()唤醒后继线程。被唤醒线程回到 acquireQueued 的自旋继续竞争锁。
子类通过重写tryAcquire()、tryRelease()等逻辑来实现自己的业务,AQS不负责实现这些,只定义公共业务模板,例如加锁、唤醒、阻塞、排队等逻辑。
ReentrantLock的实现原理
ReentrantLock是JDK提供的可重入锁实现,相比于synchronized,具有以下特点:
可中断。即获取锁的过程可以被打断,被打断会抛出InterruptedException,视为获取锁失败。
可以设置超时时间,如果超过一定时间还没有获取锁就会放弃获取锁。
可以设置公平锁(synchronized是非公平锁)。
支持多个条件变量。每个线程可以在不同的条件变量的队列上等待,这使得可以更精准的唤醒条件满足的线程。
ReentrantLock基于CAS和AQS实现,支持可重入、公平和非公平锁、可中断锁、条件变量等特性。
state在ReentranLock中的含义:state = 0表示锁空闲;state > 0表示锁被占用,state的值表示重入次数。
ReentranLock支持公平锁和非公平锁,在构造方法中指定fair参数。
 public ReentrantLock(boolean fair) {
     sync = fair ? new FairSync() : new NonfairSync();
}lock()加锁流程。如果当前的锁是非公平锁,则新来的线程会直接尝试CAS修改state,修改成功则代表抢锁成功,即使有些线程已经等待很久了,这就是非公平的体现;如果当前是公平锁,则会进入CLH阻塞队列等待,这就是公平的体现,先到的线程先获得锁。
// 非公平锁抢锁流程
final void lock() {
// 第一步:CAS 尝试直接抢锁,不管队列里有没有人在等
if (compareAndSetState(0, 1))
setExclusiveOwnerThread(Thread.currentThread()); // 抢到,标记持有者
else
acquire(1); // 没抢到,进入 AQS 排队流程
}
// 公平锁抢锁流程
final void lock() {
acquire(1); // 不先 CAS,直接排队
}unlock()解锁流程。在内部会直接调用AQS的release()方法,在方法内部会判断队列中是否还有线程在等待,如果有则唤醒后继线程。
public void unlock() {
sync.release(1);
}
public final boolean release(int arg) {
if (tryRelease(arg)) {
signalNext(head);
return true;
}
return false;
}Conditon条件变量。ReentrantLock支持创建多个条件变量,每个条件变量拥有独立的等待队列,因不同条件阻塞的线程可以存放在不同的条件变量中,当条件满足时,只唤醒对应条件变量的线程,可以减少虚假唤醒,提高效率。
线程池的原理
应用会为每个到达的请求都创建一个处理请求的线程, 当请求流量较大时,会创建大量的线程,而CPU根本无法同时运行这么多线程,此时上下文开销就会变得非常大,并且频繁地创建线程还会占用大量内存,导致应用性能下降,因此我们需要一个管理线程的容器,这就是线程池所解决的问题。
线程池可以用来管理线程,当提交任务时,线程池会将任务提交给其中的线程完成工作,任务数量较多时会将任务保存在阻塞队列中。在Java中创建线程池可以使用JDK提供的ThreadPoolExecutor类来创建线程池,每个ThreadPoolExecutor就代表一个线程池,其包括如下参数:
corePoolSize:核心线程数,可以理解为线程池中常驻的线程数量。
maxmiumPoolSize:最大线程数,等于核心线程数 + 应急线程数。
keepAliveTime:应急线程的存活时间。
unit:存活时间的单位,可以取毫秒、秒等。
workQueue:阻塞队列,当核心线程全部忙时新提交的任务会进入该队列。
threadFactory:线程工厂,指定了线程池创建线程的方式。
handler:拒绝策略,当阻塞队列已满且线程数也达到最大线程数时触发。拒绝策略共有四种。
AbortPolicy:直接抛出异常,默认策略。
CallerRunsPolicy:由调用者所在线程执行该任务。
DiscardOldestPolicy:丢弃阻塞队列中最早的任务,并执行当前任务。
DiscardPolicy:直接丢弃任务。
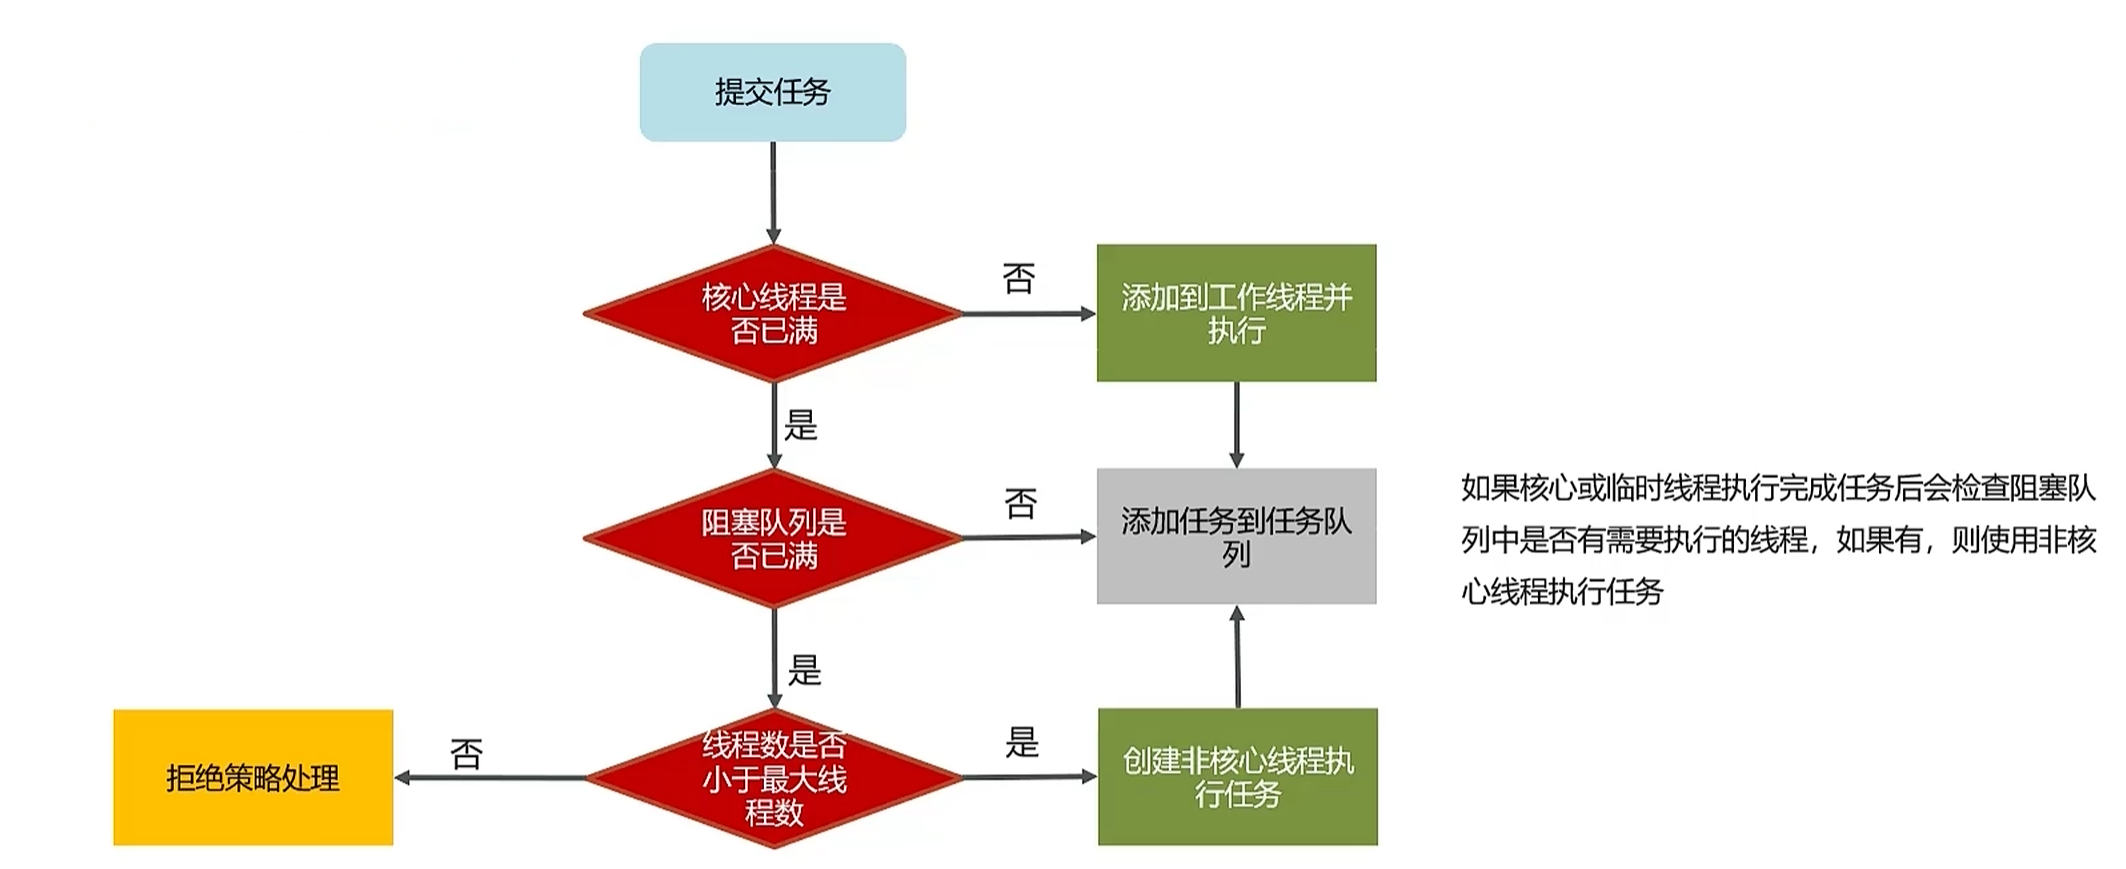
线程池的工作原理:当任务到达线程池时,线程池首先会检查是否有空闲的核心线程,如果有就直接将任务交给核心线程执行,否则检查阻塞队列workQueue是否已经满了,如果没满就插入到队列中等待执行,否则检查线程池中的线程数是否已经达到最大值,如果没有达到就创建应急线程来执行这些任务,如果线程数也达到最大值了就会触发配置的拒绝策略。
线程池的工作流程图
阻塞队列的选择
阻塞队列的选择有很多种,其中常见的包括以下四种:
ArrayBlockingQueue:基于数组实现的有界队列,有界,创建时必须指定容量,生产最常用。
LinkedBlockingQueue:基于单向链表实现,有界无界都可,但是建议指定容量,因为无界队列可能使任务堆积造成OOM。
DelayedQueue:基于数组和堆实现的优先级队列,可以保证每次出队的任务都是当前队列中执行时间最靠前的,无界,任务不断提交可能导致OOM。
SynchronousQueue:容量为0,不存储任何数据,每个
put()插入操作都必须阻塞等待对应的take()取出操作。
一般最常使用的就是ArrayBlockingQueue和LinkedBlockingQueue,后面两种使用场景较少,了解即可。
ArrayBlockingQueue和LinkedBlockingQueue对比
ArrayBlockingQueue 和 LinkedBlockingQueue 在锁机制上的区别:ArrayBlockingQueue 使单锁机制,由于入队和出队都使用的同一把 ReentrantLock ,因此入队和出队操作不能并发执行;而 LinkedBlockingQueue 使用的是双锁机制,头部和尾部各一把锁,这使得入队和出队操作可以同时进行,在吞吐量上比 ArrayBlockingQueue 表现更好。
为什么 ArrayBlockingQueue 不做双锁机制呢?因为 ArrayBlockingQueue 底层使用数组实现,而数组是连续内存,添加或删除元素都需要移动整个数组的元素,头尾操作会互相影响,因此无法实现双锁机制。
常见的线程池种类
在 java.util.concurrent.Executors 类中提供了大量创建连接池的静态方法,常见的有四种:
FixedThreadPool,使用固定线程数的线程池。
     public static ExecutorService newFixedThreadPool(int nThreads, ThreadFactory threadFactory) {
         return new ThreadPoolExecutor(nThreads, nThreads,
                                       0L, TimeUnit.MILLISECONDS,
                                       new LinkedBlockingQueue<Runnable>(),
                                       threadFactory);
     }
方法内部通过ThreadPoolExecutor的构造方法创建了一个线程池,其核心线程数和最大线程数都是相同的,因此没有应急线程,keepAliveTime也就失效了,并且阻塞队列使用的是无参构造的LinkedBlockingQueue,是一个无界队列。
适用于任务量已知,相对耗时的任务。
SingleThreadExecutor,单线程线程池
 public static ExecutorService newSingleThreadExecutor() {
     return new AutoShutdownDelegatedExecutorService
         (new ThreadPoolExecutor(1, 1,
                                 0L, TimeUnit.MILLISECONDS,
                                 new LinkedBlockingQueue<Runnable>()));
 }
方法内部ThreadPoolExecutor的构造方法中传入的核心线程数和最大线程数都是1,也就是该线程池中最多只会有一个线程,阻塞队列使用的无参构造的LinkedBlockingQueue。线程池中只有一个线程可以保证提交的任务按照提交顺序执行。
适用于需要按照顺序执行的任务。
CachedThreadPool,缓存线程池。
 public static ExecutorService newCachedThreadPool() {
     return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
                                   60L, TimeUnit.SECONDS,
                                   new SynchronousQueue<Runnable>());
 }
该线程池的核心线程数是0,意味着没有常驻线程,线程池中的线程全部都是临时线程,且临时线程数量没有上限(上限为 Integer.MAX_VALUE ),阻塞队列选择SynchronousQueue,该队列的容量为0,不存储元素,也就意味着每个新来的任务都会为其创建临时线程处理,处理完毕之后超过空闲时间就会销毁空闲线程。
ScheduledThreadPoolExecutor,带有延迟和周期执行功能的ThreadPoolExecutor。
 public ScheduledThreadPoolExecutor(int corePoolSize) {
     super(corePoolSize, Integer.MAX_VALUE,
           DEFAULT_KEEPALIVE_MILLIS, MILLISECONDS,
           new DelayedWorkQueue());
}该线程池的特点是可以执行延时任务或者周期性执行某些任务。
但是事实上在实际开发中是不建议使用Executors创建线程池的,因为Executors返回的线程池大多都有一些弊端,首先FixedThreadPool和SingleThreadExecutor的阻塞队列都是无参构造的LinkedBlockingQueue,这个队列默认容量是Integer.MAX_VALUE ,会导致大量任务一直堆积,导致OOM。CachedThreadPool允许创建的线程数量是Integer.MAX_VALUE ,如果有大量的任务提交会创建大量线程,也会导致OOM。
所以建议使用new ThreadPoolExecutor()手动创建线程池,根据实际业务选择核心线程和最大线程数,以及阻塞队列。
线程池的使用场景
线程池在实际开发中的使用场景有很多,核心目标都是利用多线程来并行执行同一个任务来提高效率。
批量数据导入:假设要将数据库中的大量数据导入到ES等外部数据库中,如果一次性导入可能因加载数据量太大导致内存溢出,此时可以实用线程池来优化性能。例如要将一千万条数据从MySQL导入到ES,可以先对数据进行分页,然后创建一个线程池,将每一页作为一个任务提交到线程池,交由线程池中的线程处理。
数据汇总:当业务需要查询多部分的数据且这些数据之间没有依赖时,可以使用线程池分别查询各部分数据并汇总。串行查询消耗的时间是所有查询时间之和,但是并行查询消耗的时间是所有查询中时间最长的那一个,可以大幅减少查询时间,提高响应速度。具体使用方法是可以将每个部分的查询结果封装在Future对象中,然后通过
get()方法在查询完成之后获取。异步调用:将非主体业务逻辑交给线程池处理,只向用户返回需要的最少数据。例如用户执行搜索操作之后,后端优先返回搜索结果,记录搜索记录这类次要逻辑可以交给线程池异步处理,提高响应速度。
ThreadLocal
ThreadLocal是多线程中对于解决线程安全的一个操作类,它会为每个线程都分配一个独立的副本从而解决变量并发访问冲突的问题,同时实现了线程内的资源共享。
ThreadLocal原理
在每个线程内部都有一个ThreadLocalMap类型的成员变量,ThreadLocalMap是ThreadLocal的内部类,也是一个存储键值对的Map双列集合,其简化定义如下:
static class ThreadLocalMap {
// 键值对定义,map中存储的实际上是该键值对数组
static class Entry extends WeakReference<ThreadLocal<?>> {
Object value;
Entry(ThreadLocal<?> k, Object v) {
super(k);
value = v;
}
}
// 初始容量
private static final int INITIAL_CAPACITY = 16;
// 实际存储元素的数组
private Entry[] table;
// 元素数量
private int size = 0;
private ThreadLocalMap() {}
ThreadLocalMap(ThreadLocal<?> firstKey, Object firstValue) {
table = new Entry[INITIAL_CAPACITY];
int i = firstKey.threadLocalHashCode & (INITIAL_CAPACITY - 1);
table[i] = new Entry(firstKey, firstValue);
size = 1;
setThreshold(INITIAL_CAPACITY);
}
// 根据key获取对应的value
private Entry getEntry(ThreadLocal<?> key) {
// 通过取模哈希来确定key的存储位置
int i = key.threadLocalHashCode & (table.length - 1);
Entry e = table[i];
// 如果对应的位置上有value则直接返回
if (e != null && e.refersTo(key))
return e;
else
// 对应位置上已经有元素了,存在哈希冲突
return getEntryAfterMiss(key, i, e);
}
// 向map中添加键值对
private void set(ThreadLocal<?> key, Object value) {
Entry[] tab = table;
int len = tab.length;
int i = key.threadLocalHashCode & (len-1);
for (Entry e = tab[i];
e != null;
e = tab[i = nextIndex(i, len)]) {
if (e.refersTo(key)) {
e.value = value;
return;
}
if (e.refersTo(null)) {
replaceStaleEntry(key, value, i);
return;
}
}
tab[i] = new Entry(key, value);
int sz = ++size;
if (!cleanSomeSlots(i, sz) && sz >= threshold)
rehash();
}
}通过entry的定义可以看到,其继承了WeakReference弱引用,泛型是ThreadLocal,即key的类型是ThreadLocal。插入元素的逻辑在set()方法内部实现,通过取模计算出key对应的数组下标并插入。获取元素的逻辑在get()方法内部实现,也是计算出key的下标之后去数组对应的位置寻找元素。
ThreadLocalMap 的哈希计算方法:每个 ThreadLocal 都有一个独一无二的 threadLocalHashCode ,这个值是一个AtomicInteger 类型的变量,是 TheadLocal 的静态成员变量,每次创建 TheadLocal 时,都会将这个原子整数赋值给该 ThreadLocal 的 threadLocalHashCode 并递增,并且由于 AtomicInteger 是线程安全的,因此每个 ThreadLocal 的 hashcode 都是独一无二的。将这个 hashcode 与 table 数组的长度减一做按位与运算( len 的长度是2的幂,等价于取模,这点参考 HashMap 的设计)得到下标。
不同于 HashMap,ThreadLocalMap 处理哈希冲突的方法是开放寻址法:当发现数组中对应下标的位置上已经有元素时,说明发生了哈希冲突,此时 ThreadLocalMap 会不断将下标递增,并查看该位置上是否已经存在元素,如果不存在就将元素放到该位置上,存在则继续向后遍历,该方法也被称为线性探测法。
以上是ThreadLocalMap的定义,那么ThreadLocal是如何通过这个map保证线程安全的呢?ThreadLocal的核心方法共有三个:get(),set(),remove(),分别对应获取线程中的数据、向线程中添加数据、删除线程中的数据副本。
// 获取存储在当前线程的数据
private T get(Thread t) {
ThreadLocalMap map = getMap(t);
if (map != null) {
ThreadLocalMap.Entry e = map.getEntry(this);
if (e != null) {
@SuppressWarnings("unchecked")
T result = (T) e.value;
return result;
}
}
return setInitialValue(t);
}
// 向线程中和存储数据
public void set(T value) {
set(Thread.currentThread(), value);
if (TRACE_VTHREAD_LOCALS && Thread.currentThread().isVirtual()) {
printStackTrace();
}
}
private void set(Thread t, T value) {
ThreadLocalMap map = getMap(t);
if (map != null) {
map.set(this, value);
} else {
createMap(t, value);
}
}
// 删除线程中的数据
public void remove() {
remove(Thread.currentThread());
}
private void remove(Thread t) {
ThreadLocalMap m = getMap(t);
if (m != null) {
m.remove(this);
}
}可以看到,不论是get方法还是set方法,内部处理逻辑都是类似的,都是先获取当前线程,然后以当前ThreadLocal为key,在当前线程的ThreadLocalMap中寻找对应的值,获取或保存元素的流程在前面已经讲解过了。
可以把ThreadLocal想象成一把钥匙,在每个线程中都有一个独立的房间,存储该线程的相关数据,只有用这把ThreadLocal才可以打开并获取其中的数据,但是每个线程中房间存储的数据都是不同的,这样就避免了共享,使得线程之间互不干扰了。
ThreadLocal的内存泄露
ThreadLocal是存在内存泄露风险的,当ThreadLocal的强引用被置为null时,此时该ThreadLocal只有一个弱引用指向它(线程的ThreadLocalMap中的entry),因此在下一次GC时,ThreadLocal就会被回收,但是由于entry中的value是强引用,无法被自动GC,因此当ThreadLocal会回收之后,我们就没有办法再去获得到该value的引用了,直到线程销毁,这就造成了内存泄露。如果线程是线程池中的核心线程,那么该部分内存就永远不会被回收了,那么随着应用运行的时间越来越长,内存泄露会越来越严重,直到OOM。
这要求我们在使用ThreadLocal完之后必须调用remove()手动释放内存,同时不建议在ThreadLocal中存储大对象,因为这会使线程占用的内存变大。
为什么 ThreadLocal 明明知道会存在内存泄露为什么还不将 value 也设置为弱引用?假如将 value 也设置为弱引用,那么当向 ThreadLocal 中保存数据的方法调用完成之后,value 的外部引用会被回收,此时 value 只有一个弱引用指向它,这意味着 value 随时会被 GC ,在后续的业务处理流程中就无法获取到这个数据了,这是绝对不允许的。
总的来说,线程的私有数据并不是存在于ThreadLocal中的,而是存在于线程本身的ThreadLocalMap中,ThreadLocal只是获取每个线程这部分数据的key,ThreadLocal适用于需要保存线程上下文信息的场景中,例如同一个业务链路中多个方法都需要使用用户信息,为了避免反复查询同一个用户的信息,可以将用户信息保存在线程上下文中,需要时直接获取即可。